DTMや電子楽器、オーディオ関係を研究・開発する人たちが世界中から秋葉原に集まったイベントADC Japan 2026。そこで発表された、さまざまな技術、トピックスについてこれまで5回にわたって紹介してきました。開催されたのが2026年6月1~3日だったので、だいぶ時間が経ってしまいましたが、今回がその最終回。ここで紹介するのは、ADC Japan会場でひときわ大きな注目を集めていた、ローランド株式会社と株式会社Neutone(ニュートーン)が共同研究しているAIオーディオ・エフェクト「Project LYDIA(プロジェクト・リディア)」についてです。
展示スペースには専用ブースが設けられ、セッションも複数用意されるなど、まさに今回のADC Japanの目玉のひとつでした。今回はその中の一つ、6月1日に行われたワークショップセッション「Hands-on with LYDIA」の様子を中心に、Neutoneのエンジニア、TomさんとAlfieさんによる技術解説とハンズオン、さらに開発を主導するローランドのCloud本部・本部長の岡村洋司さん、矢澤一郎さん、Neutone CEOの徳井直生さんへのインタビューも交えてお届けします。

RolandとNeutoneが共同で研究開発するAIオーディオエフェクト、Project LYDIA
Project LYDIAとは何か
LYDIAは、ローランドの研究開発部門「Roland Future Design Lab」と、AIオーディオ技術を手がけるNeutoneの共同研究プロジェクトです。2025年11月12日、英国ブリストルで開催されたADC Bristolでプレビュー版として初公開されました。名前の「LYDIA」は「DIY」と「AI」の融合を意味するとのことで、ミュージシャンやエンジニアが試行錯誤しながら音楽を作り上げてきたDIY文化と、AI技術を融合させることを目指すプロジェクトです。
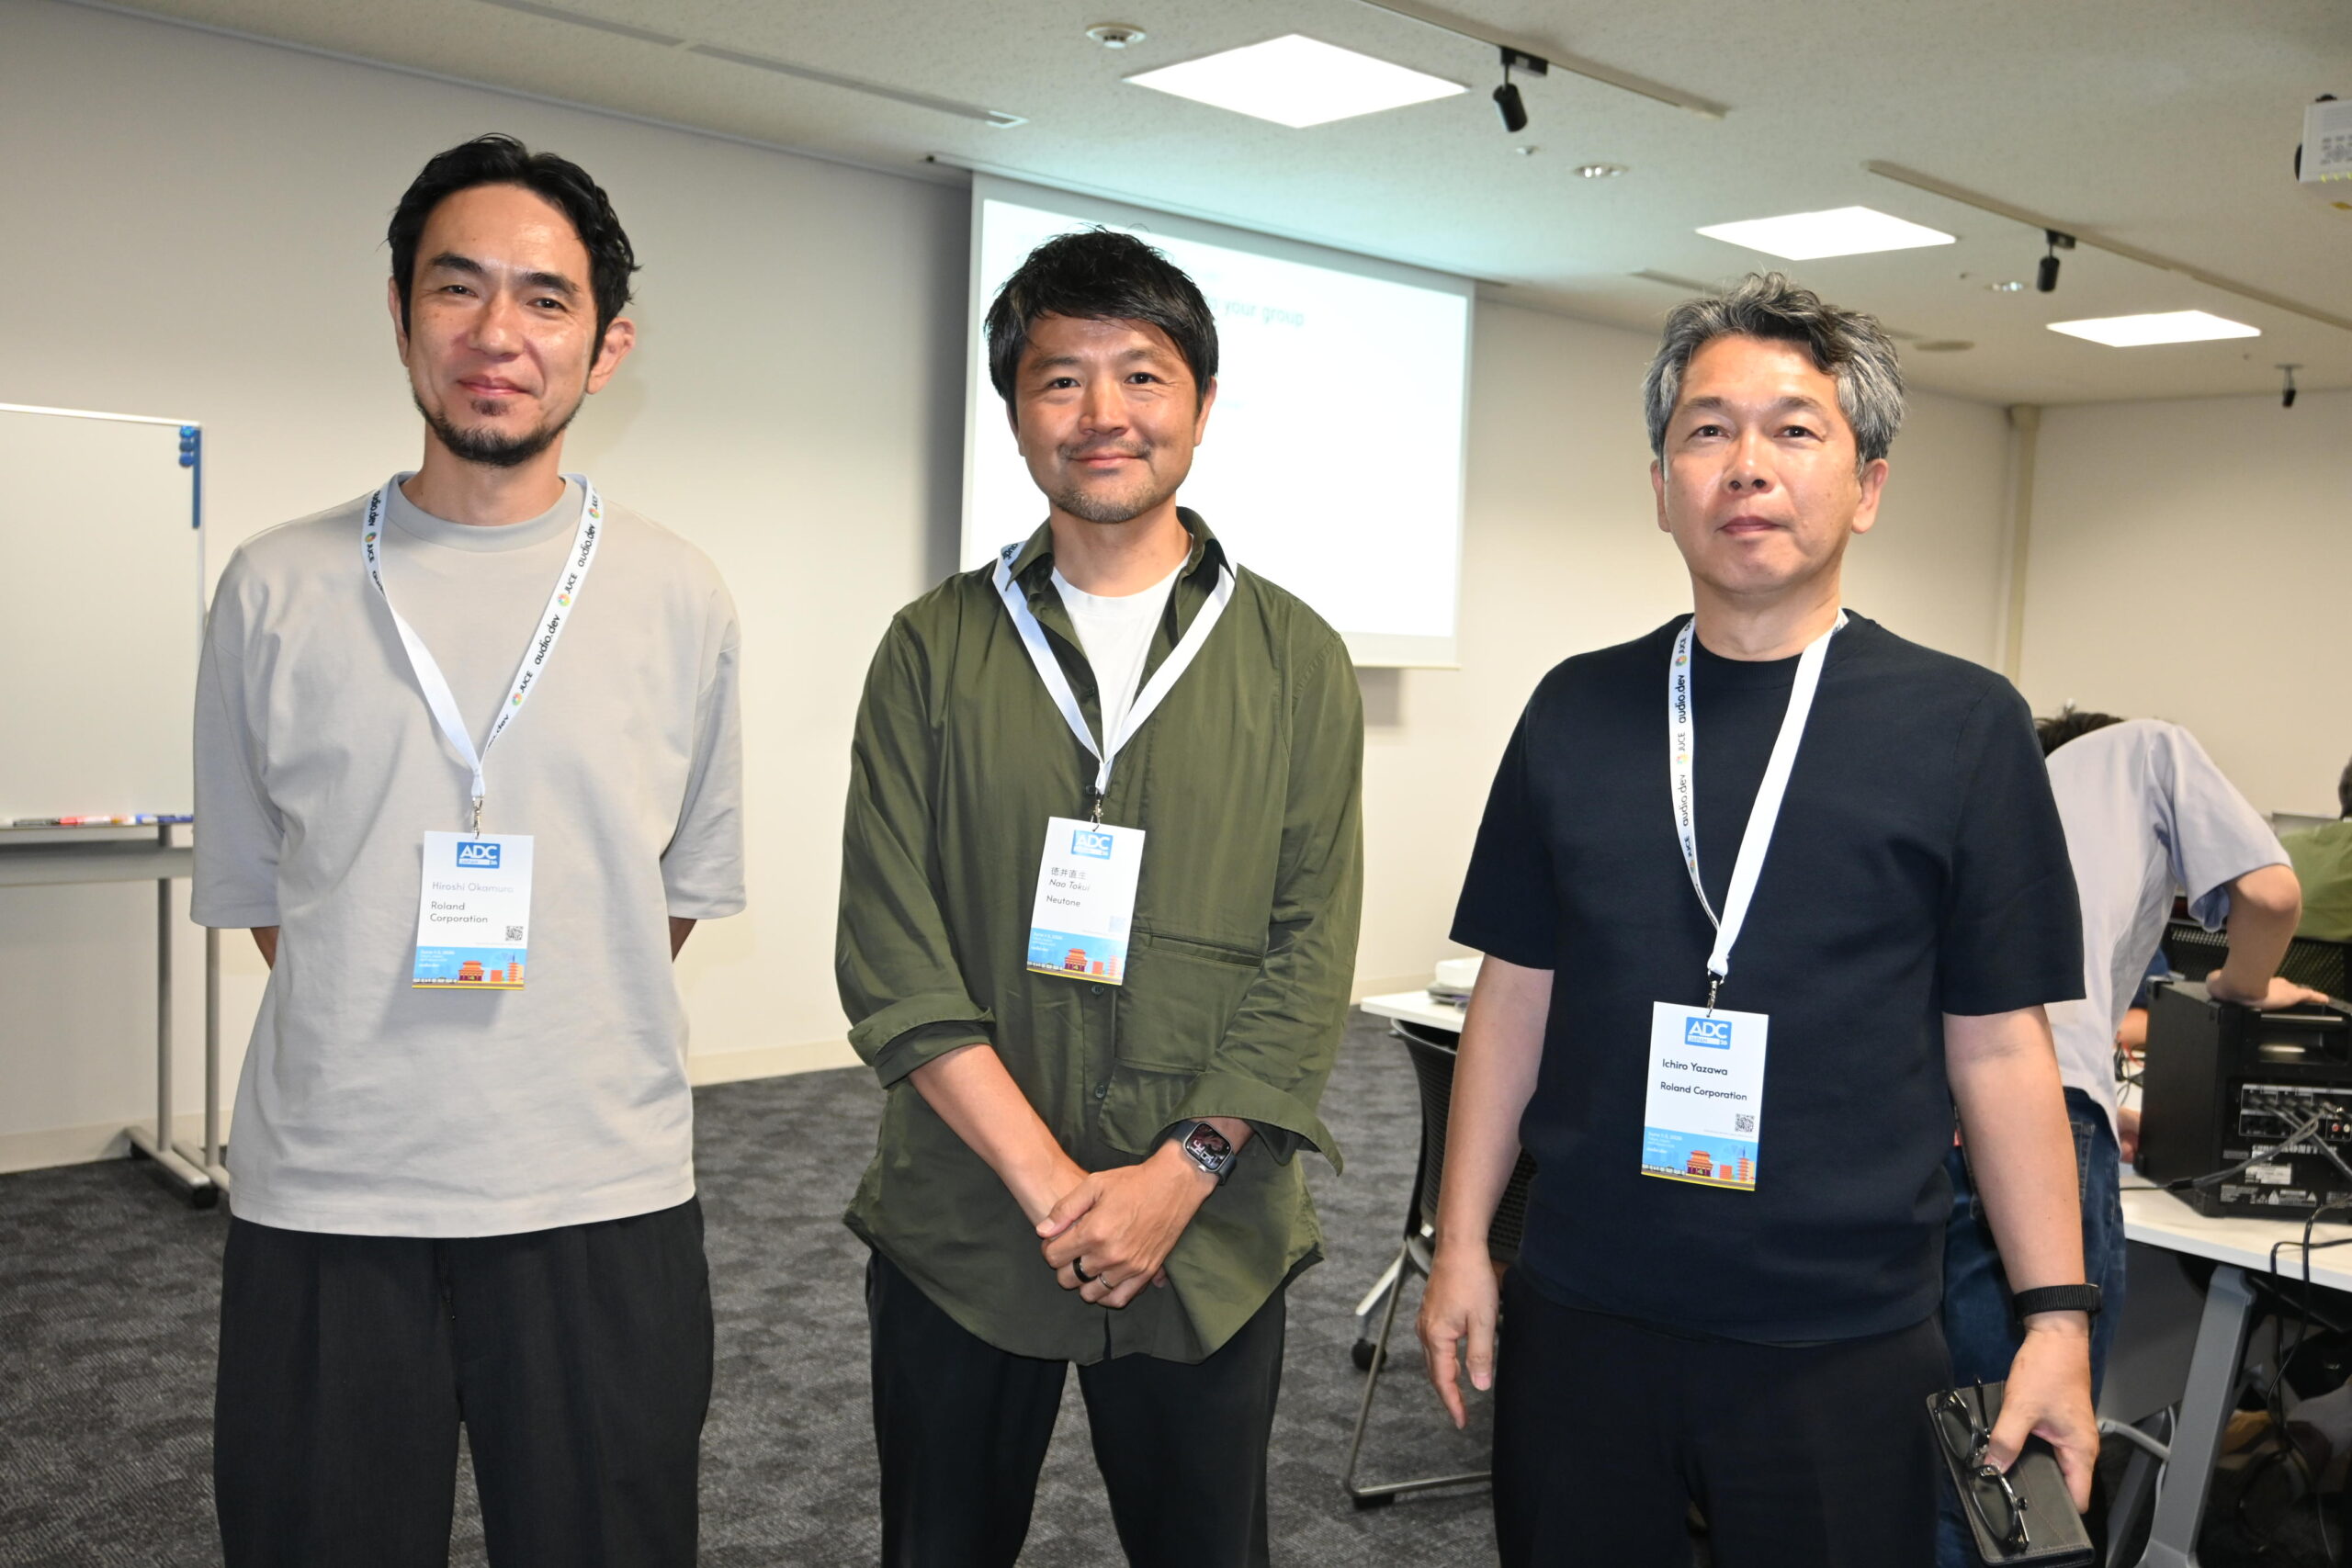
左からRolandの岡村洋司さん、Neutoneの徳井直生さん、Rolandの矢澤一郎さん
Project LYDIAはMorphoそのものを指す名称ではなく、より大きな枠組みのプロジェクトです。その第一弾として、Neutoneが開発した「Morpho(モーフォ)」技術によるニューラル・サンプリングを使ったペダルタイプのプロトタイプが、現在試作されています。Morphoは、ユーザーが用意した音源の特性をAIに学習させ、その特性を入力音声にリアルタイムで反映させることで、新しい音づくりを可能にする技術です。試作機はRaspberry Pi 5をベースに、Morphoによる AIソフトウェアと、ローランドが設計したシンプルなコントロールパネルを組み合わせた構成になっています。
「Hands-on with LYDIA」——技術解説から実機体験まで
今回取材したセッションは、単なる講演形式ではなく、参加者が実際にLYDIA実機に触れる約2時間のワークショップでした。スケジュールは「LYDIAのパラメータとWebアプリの説明(10分)→自分のモデルで遊びながらマクロを作成(25分)→グループへのモデル紹介(10分)→グループジャムセッション(20分)→個人プレゼンテーション(45分・1人3〜4分)」という構成。参加者は事前に自分の音源(1〜2時間分)をNeutoneのクラウドに提出しており、当日はその音源から学習済みの自分専用モデルが実機に読み込まれた状態でワークショップが始まります。プログラミングの知識は一切不要で、ノブ操作だけで自分だけのオーディオエフェクトを探っていくという内容でした。
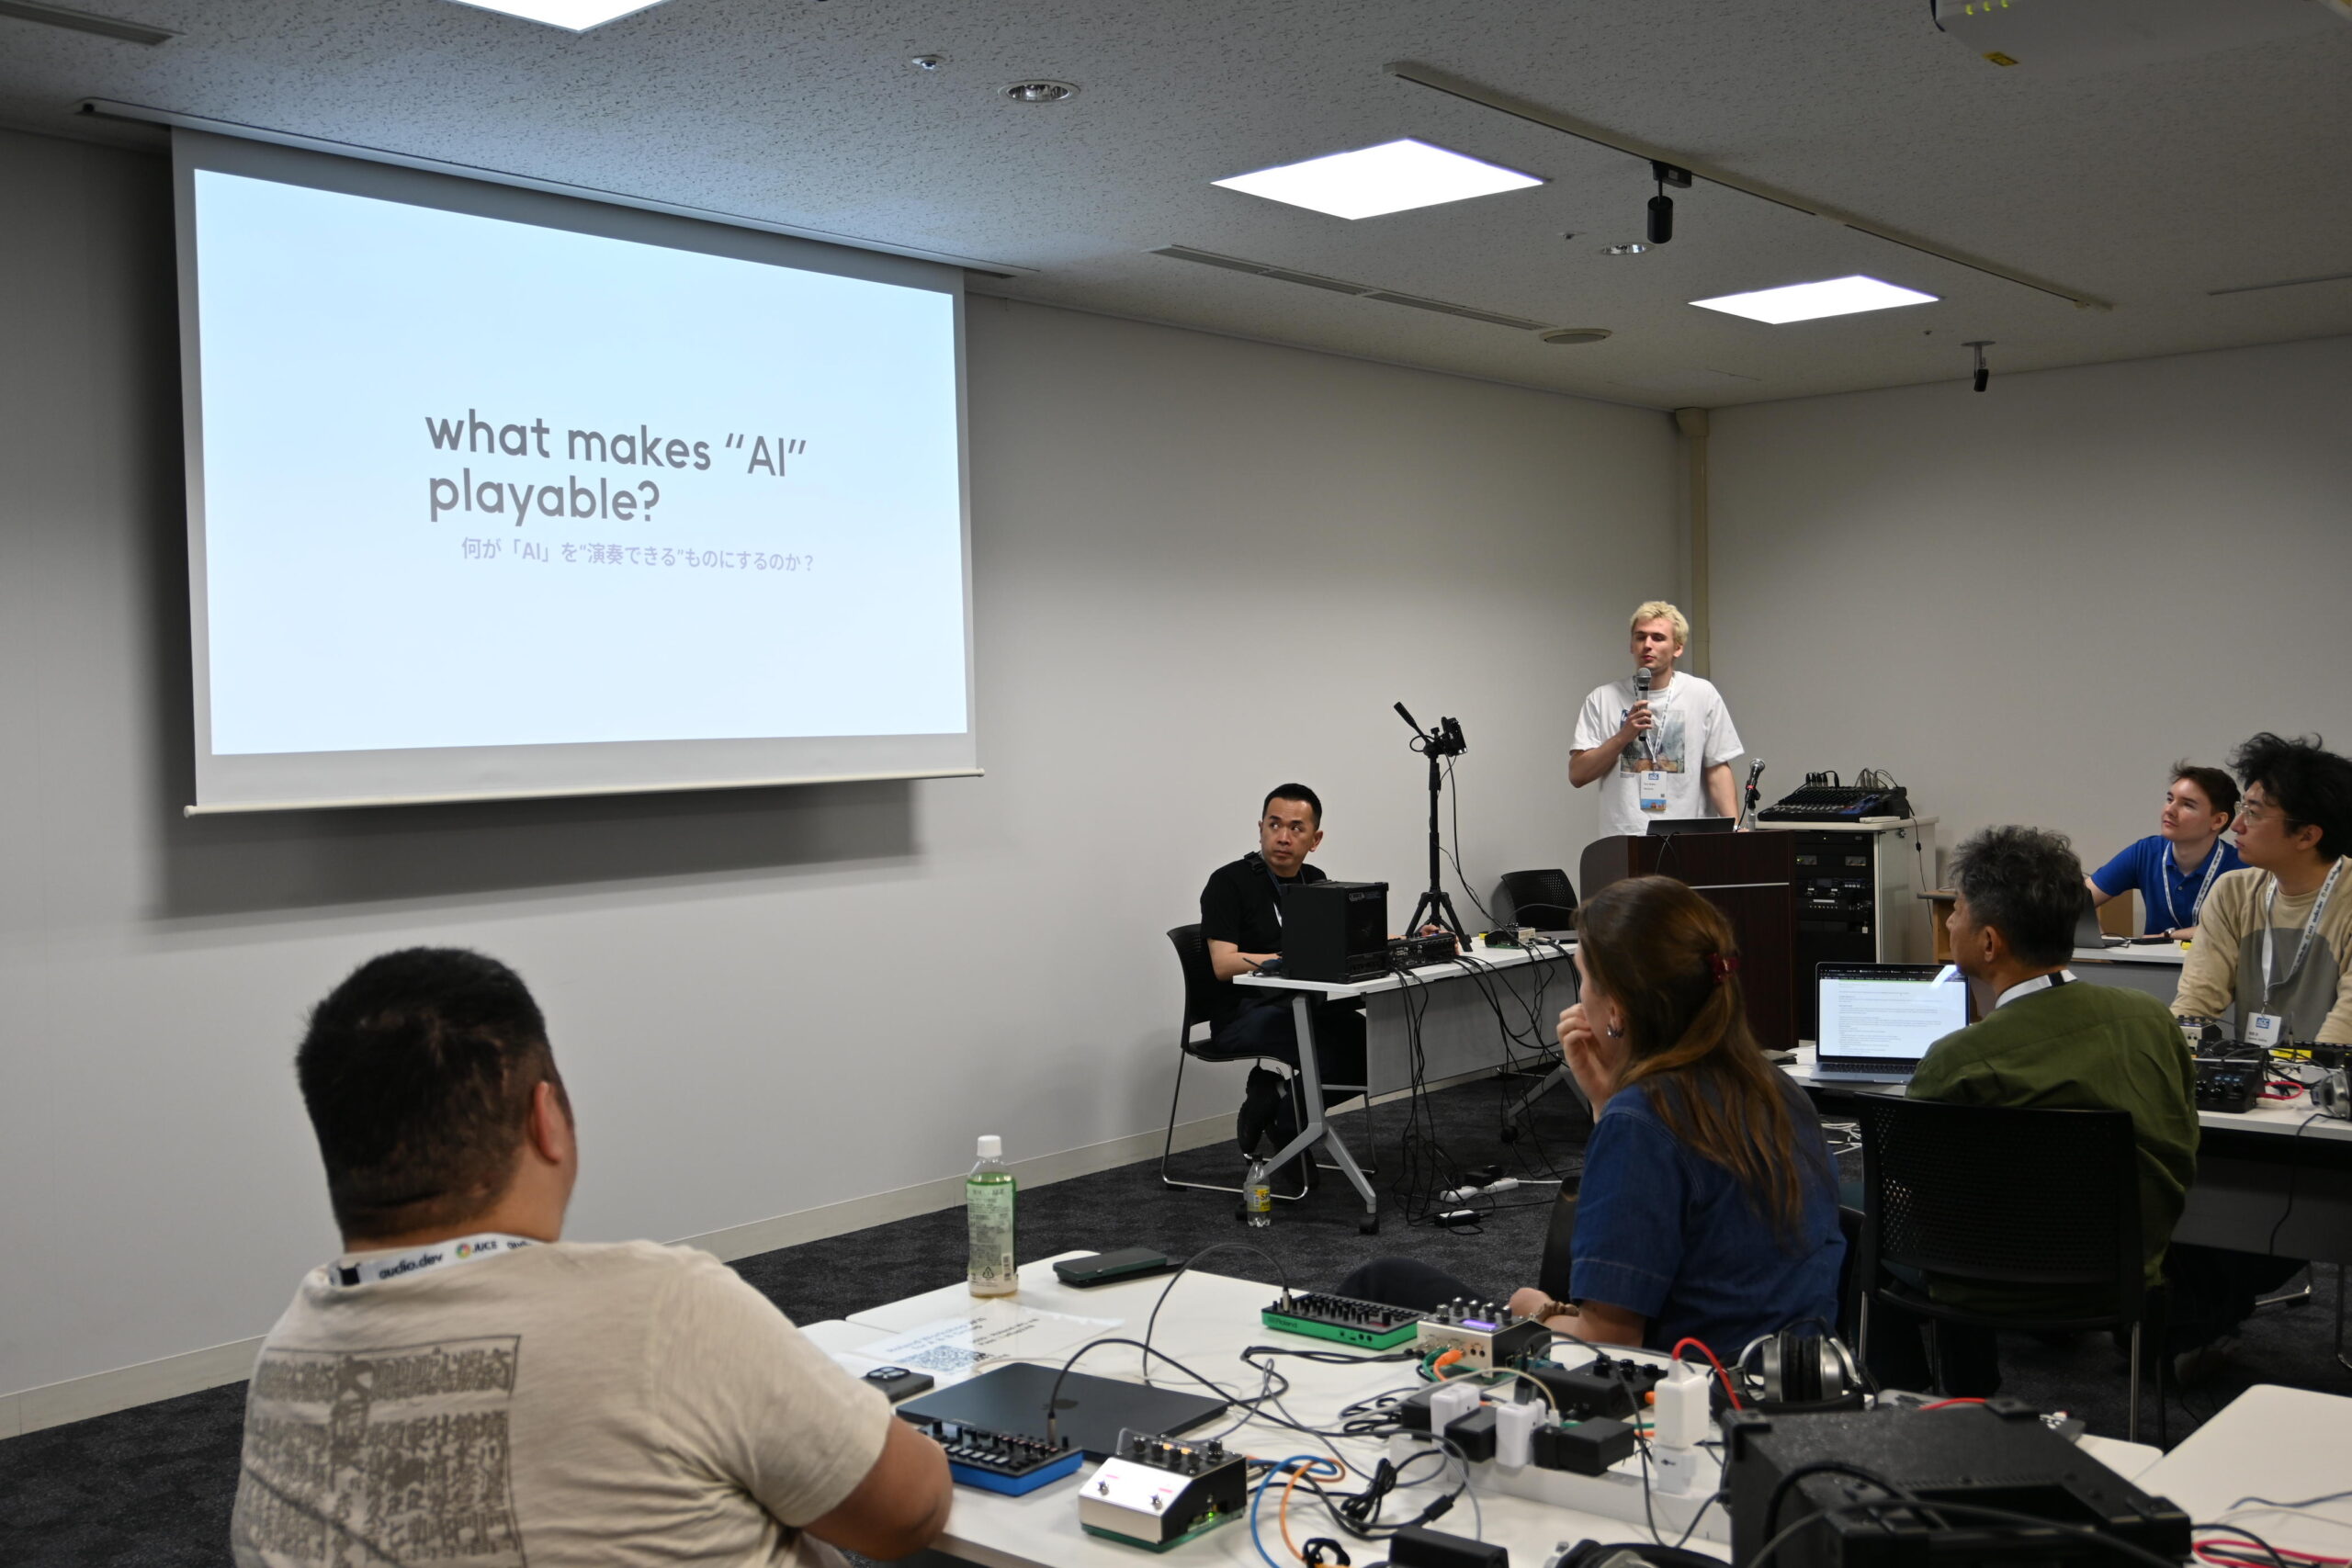
NetoneのTomさんによる技術解説
前半はNeutoneのTomさんが技術的な背景を解説し、後半は同じくNeutoneのAlfieさんが実機を使ったハンズオンパートを担当するという二部構成です。
Tomさんが語るLYDIAの頭脳——なぜVAEなのか
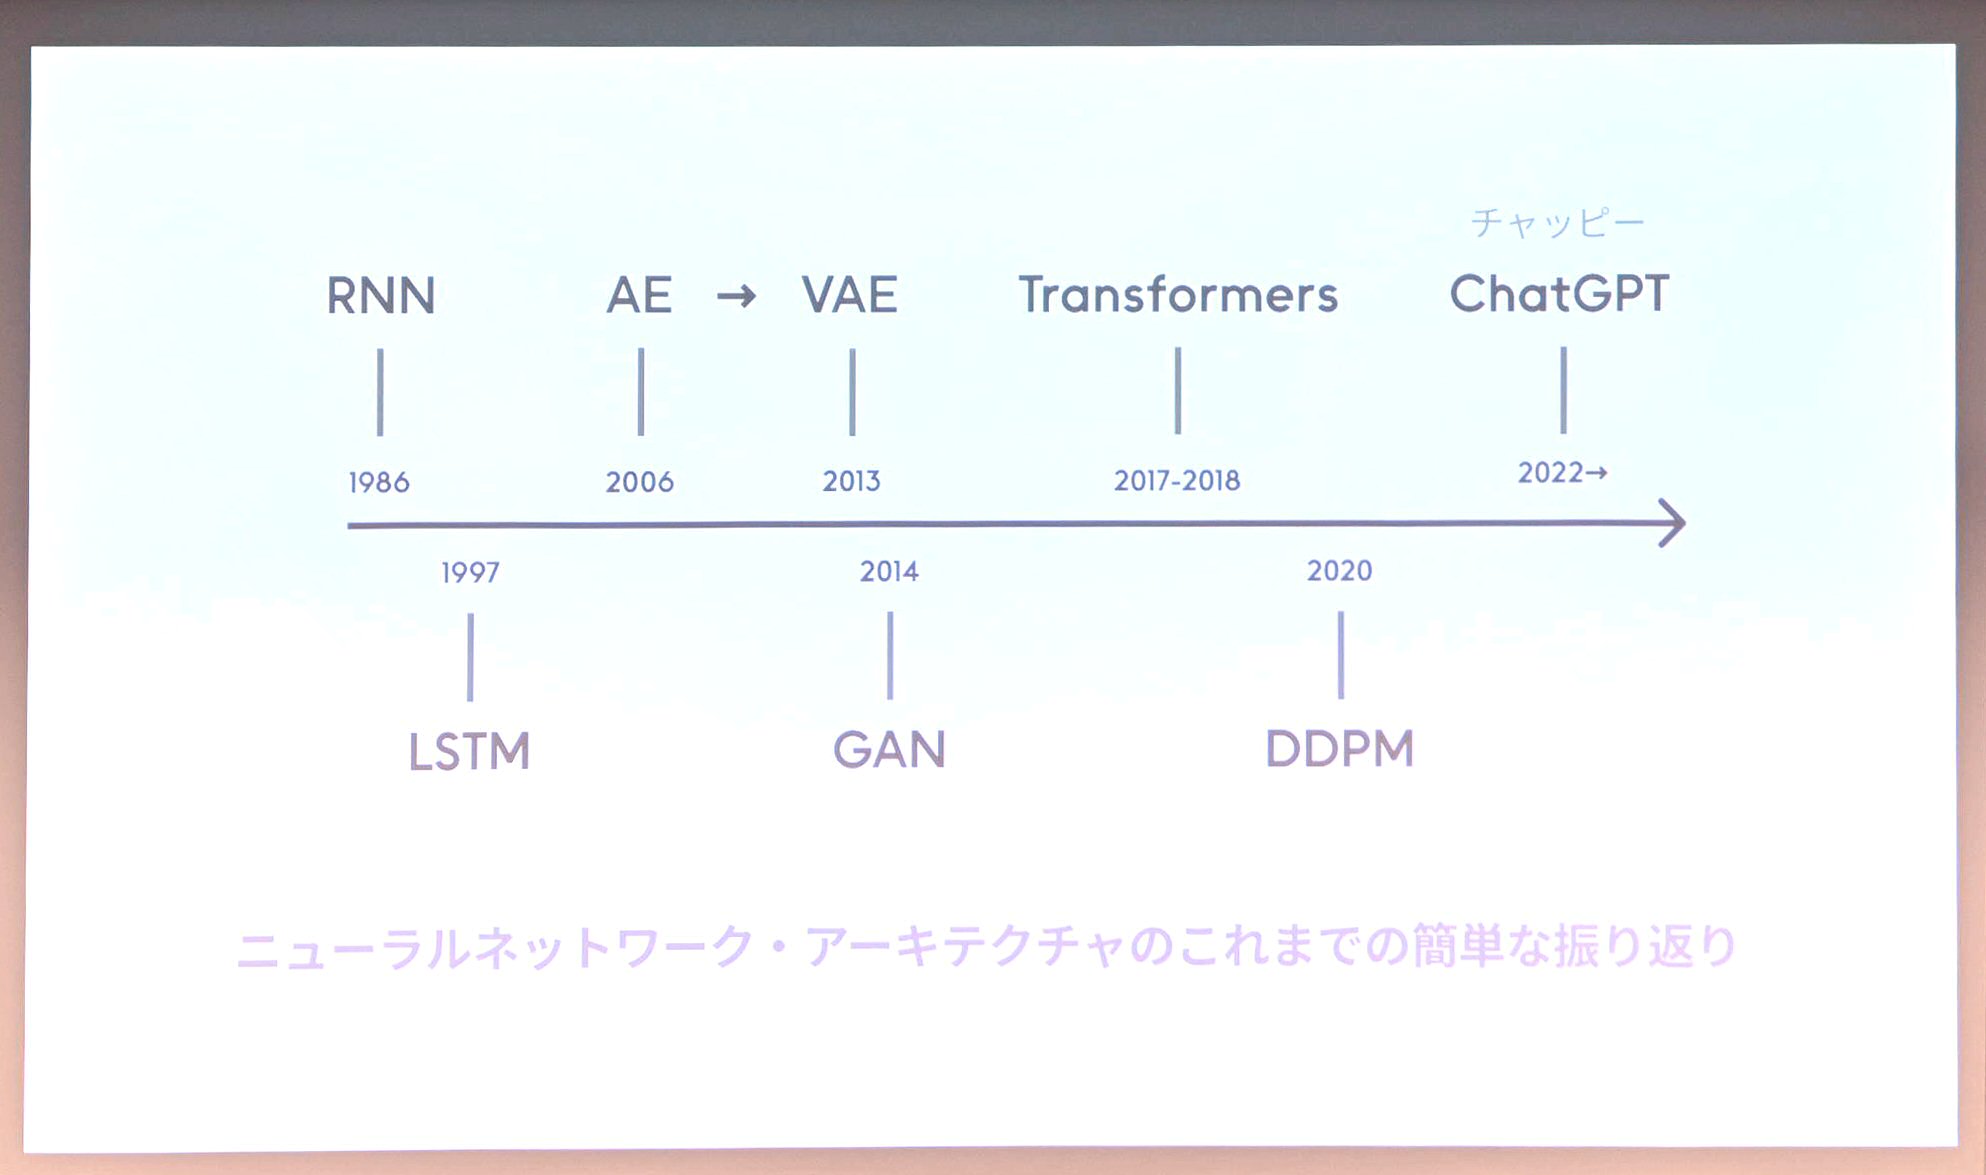
Tomさんのパートは、現在のAI音楽生成モデルの歴史を振り返るところから始まりました。RNN(1986年)・LSTM(1997年)に始まり、オートエンコーダー(AE、2006年)からVAE(Variational Autoencoder、2013年)へ、そしてGAN(2014年)、Transformers(2017〜2018年)、DDPM(2020年)を経て、ChatGPT(2022年〜)に至るという流れです。中でもRNN/LSTMは軽量なサンプル単位の処理が可能なため、現在もニューラルアンプやエフェクトのモデリングに使われている技術だと説明されました。
Google「Lyria 3」やSUNO、ElevenMusicのような「巨大なモデル」は、クラウドの計算資源を前提とした非リアルタイムの生成に強い一方、「まだ遊べない」——つまり演奏のようにインタラクティブに操作することには向いていない、というのがTomさんの指摘です。LYDIAが目指すのは、こうした大規模生成モデルとは異なる方向性、すなわち楽器のように反応してくれるAIエフェクトです。
その基盤技術として選ばれたのがVAE(オートエンコーダー)です。「input→encoder→latent→decoder→output」という構造で、入力データを少ない次元(潜在表現)に圧縮し、そこから再構成します。例えば1つのドラムサンプルを、人間にわかりやすく言えば「loudness(音量)」「pitch(ピッチ)」「noise(ノイズ量)」といった特徴量にエンコードする、というイメージです。ただしTomさんは「learned ≠ interpretable(学習された≠解釈可能)」と強調し、実際にモデルが学習する特徴量は、必ずしも人間が理解しやすい音楽的特徴と一致するわけではないと説明しました。データの中で最も「活性」な成分を見つける主成分分析(PCA)によって次元削減を行うと、より知覚可能な音色的特徴に近い軸が得られやすい、という補足もありました。
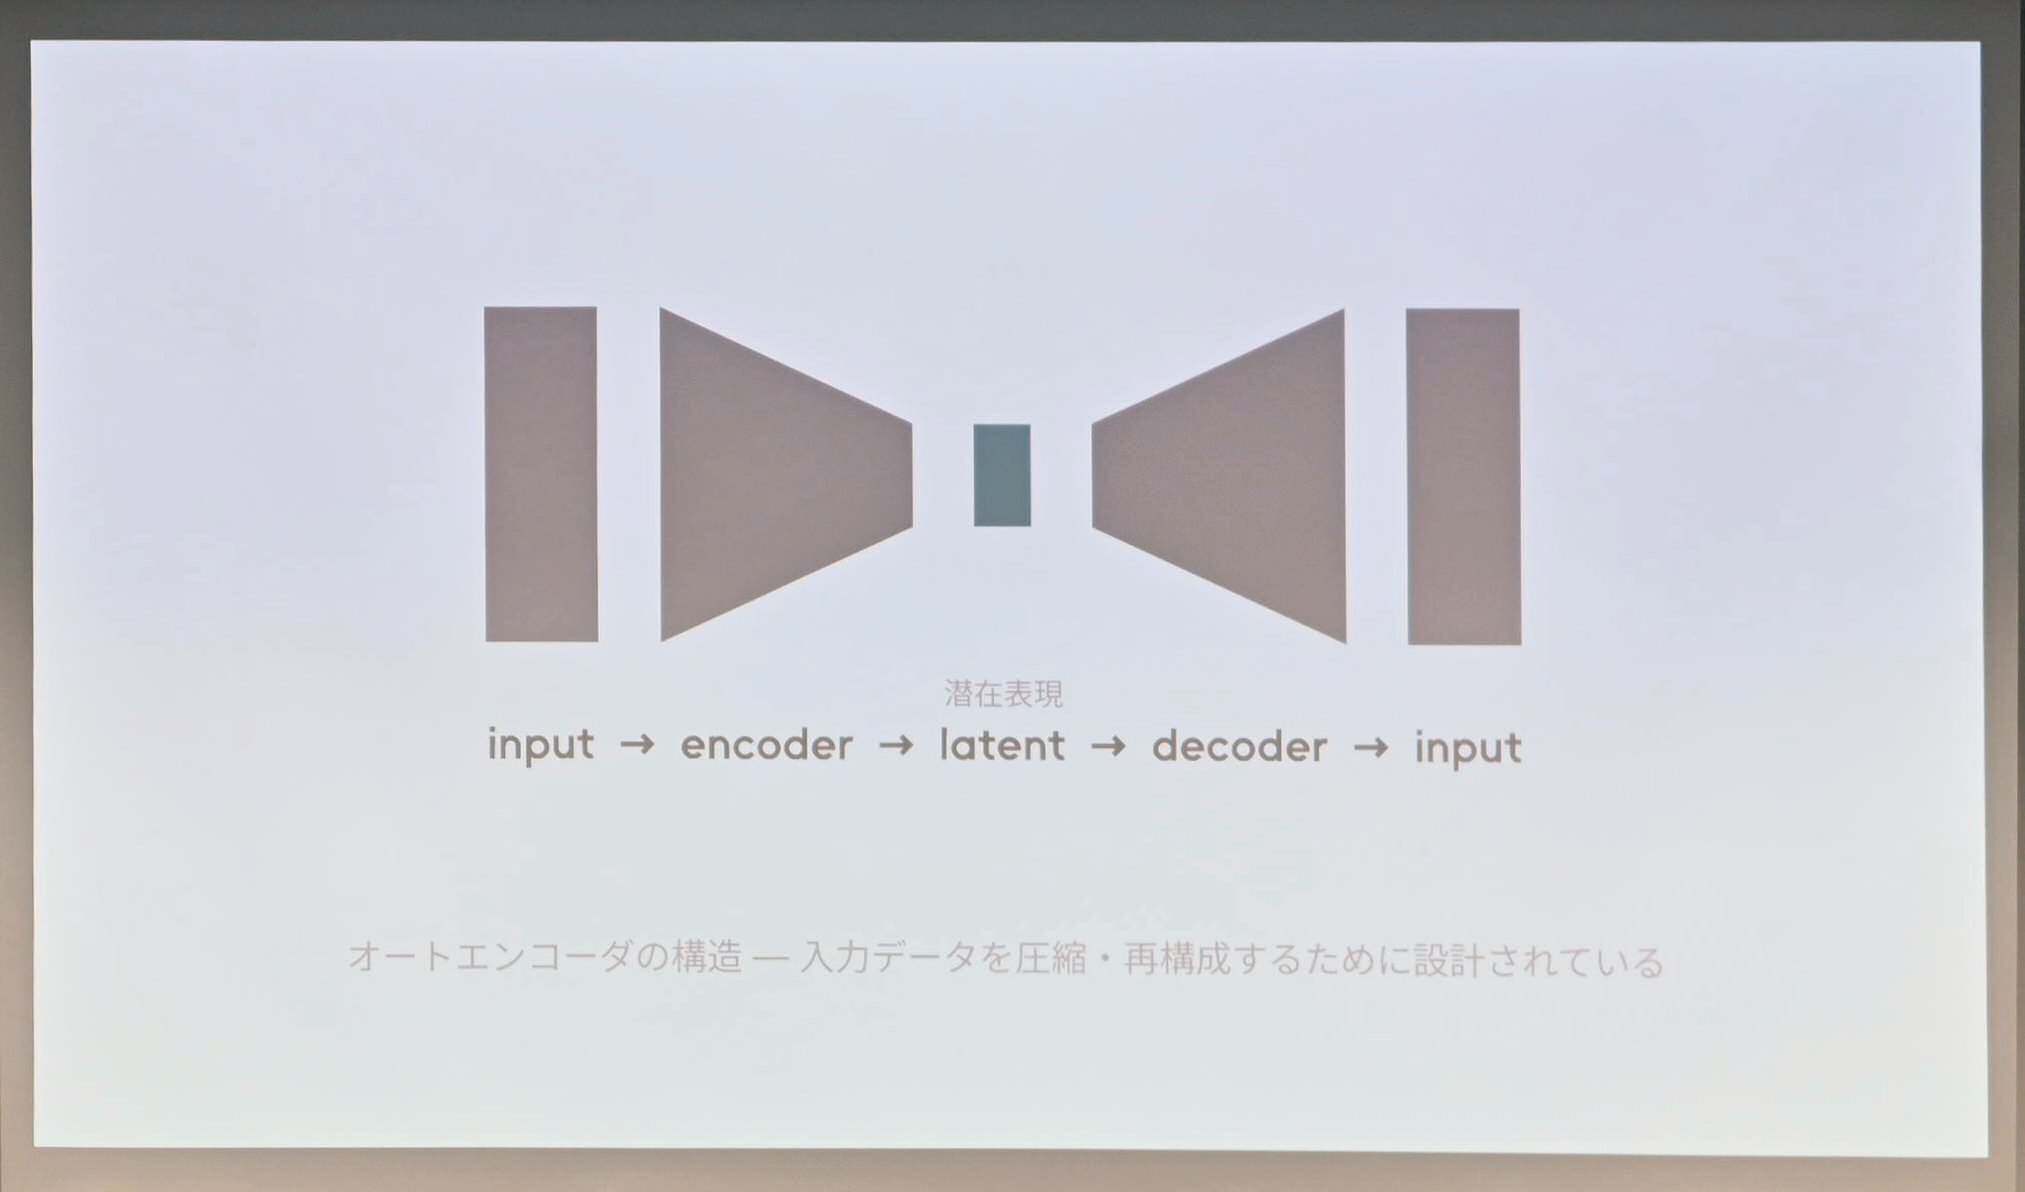
さらに、単なる再構成(reconstruction)だけでは不十分だとして、VAEに「discriminator(識別器)」を組み合わせる敵対的学習(adversarial training)の話に進みます。識別器は出力が本物か偽物かを、ノイズや不自然な滑らかさを手がかりに判定するだけですが、これによって潜在空間の中間からサンプリングされた点も、本物の音のように「聞こえる」ようになるとのことです。
ストリーミング処理という壁——「未来は見えない」
技術解説の後半は、こうしたモデルをリアルタイムのストリーミング処理に落とし込む難しさに焦点が当たりました。「どうすればストリーミング可能になるのか?」という問いに対し、Tomさんが挙げたのは「we can’t see the future(未来は見えない)」という制約です。STFT(短時間フーリエ変換)のように通常はホップ幅を窓(ウィンドウ)の中心に合わせますが、これは出力生成までに大きな遅延を生んでしまいます。
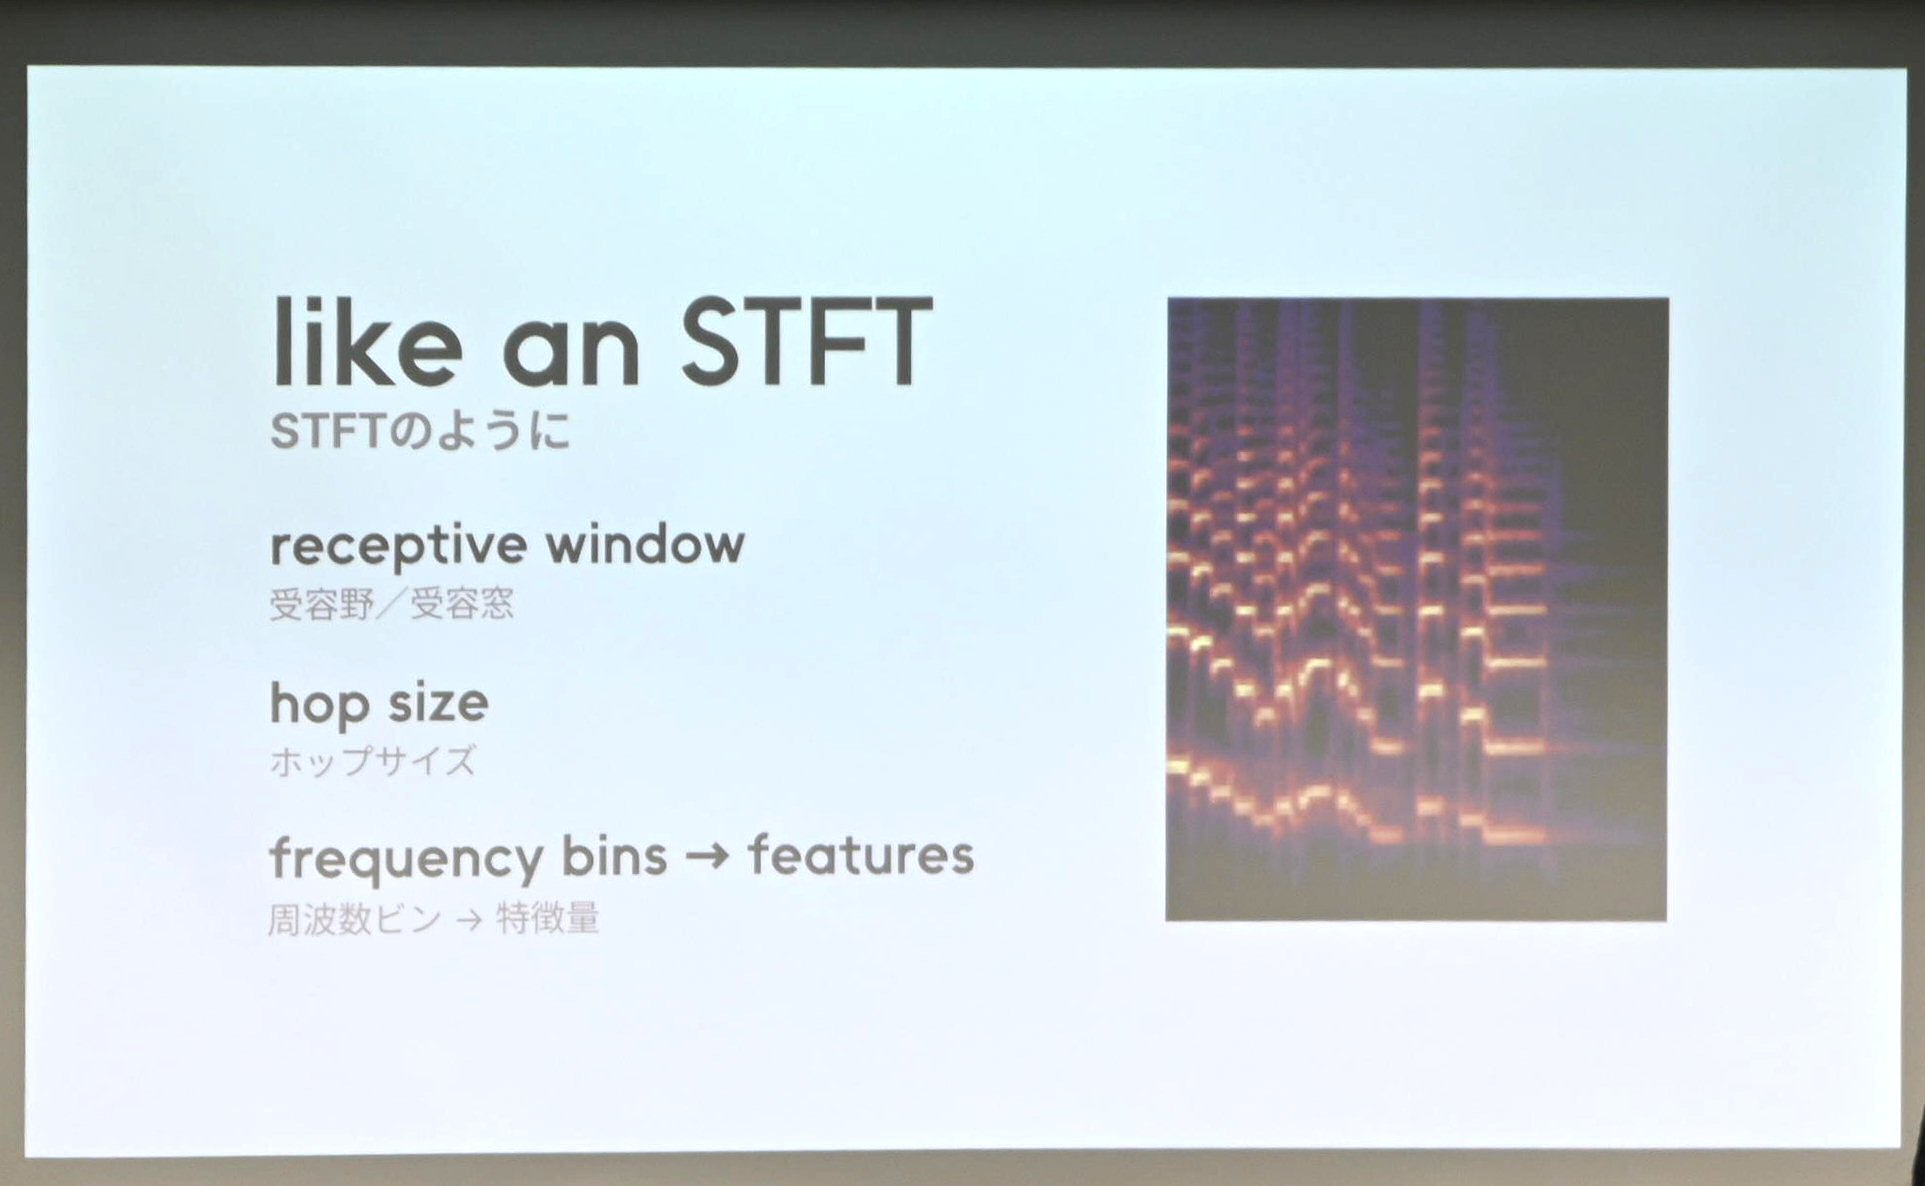
そこで、ホップを受け取ると同時に処理して出力できるよう窓をずらす工夫や、「大きな窓・小さなホップ(big window, smaller hop)」によって計算コストと情報量のバランスを取る手法が紹介されました。ホップ幅は音質とレイテンシーのトレードオフに直結するため固定した上で、モデル自体を最適化していく——これが「the latency floor(レイテンシーの下限)」というスライドの主旨です。
具体的な最適化手法としては、「synthesis priors(合成事前知識)」——マルチバンド処理、フィルタ済みノイズ、逆フーリエ変換といったDSP的な知見をモデルに組み込むことで計算負荷を軽減する手法や、Pythonで書かれたモデルをONNX形式にエクスポートし、C++ランタイム上で効率的に実行する「scripting the model」という手法が紹介されました。最終的にこれらのモデルは、JUCEアプリケーションやハードウェアに組み込まれる、という流れで技術解説パートは締めくくられました。
Alfieさんによる実機ハンズオン——ディメンションパラメータとダイナミクス
後半は同じくNeutoneのAlfieさんが登壇し、実機を使ったハンズオンに移ります。LYDIA実機はエフェクターペダルのような筐体で、「Roland RFDL」と「neutone」のロゴが確認できます。
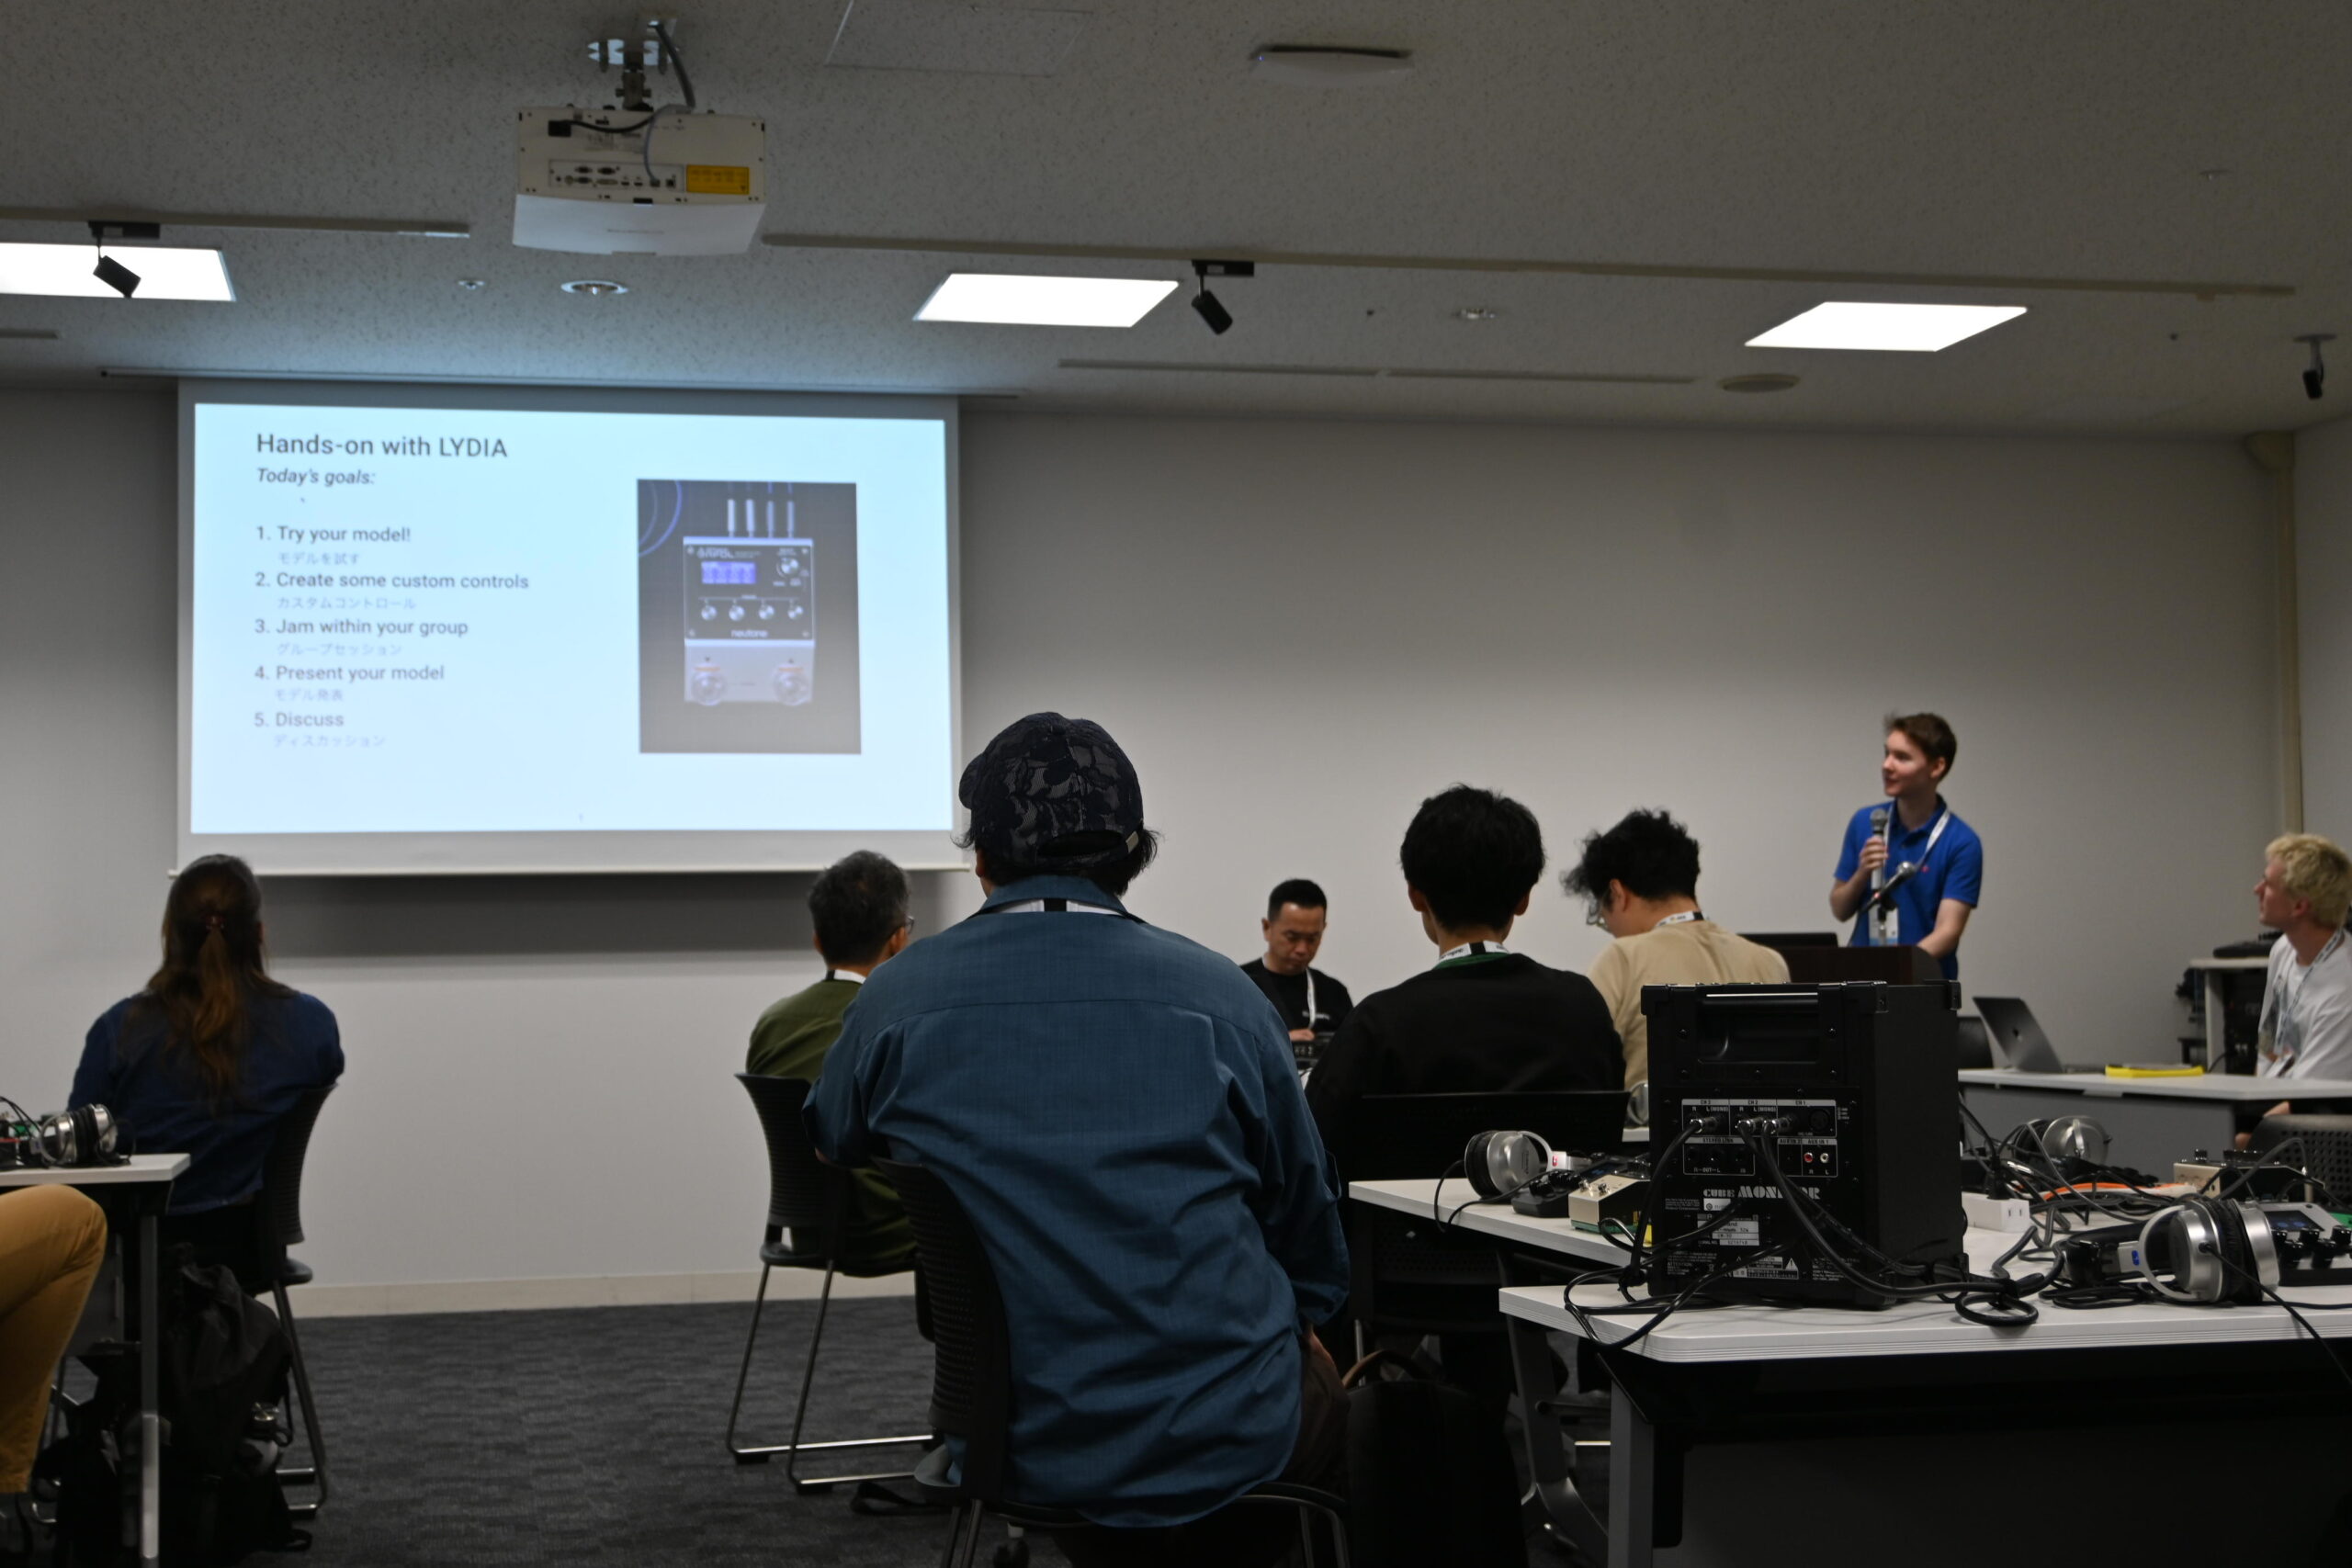
NeutoneのAlfieさんによるLYDIAのハンズオンセッション
ここで解説されたのが「ディメンションパラメータ」です。VAEの潜在表現(エンコーディング)にオフセットを加えることで音を変化させる仕組みで、PCA(主成分分析)によって「Dimension 1が最も支配的、Dimension 6が最も影響が小さい」という順に並べられています。実機の画面には「Dyn(Dynamics)」「Dim1」「Dim2」「Mix」といったノブと、「IN→MODEL→FX→OUT」という信号の流れが表示されていました。
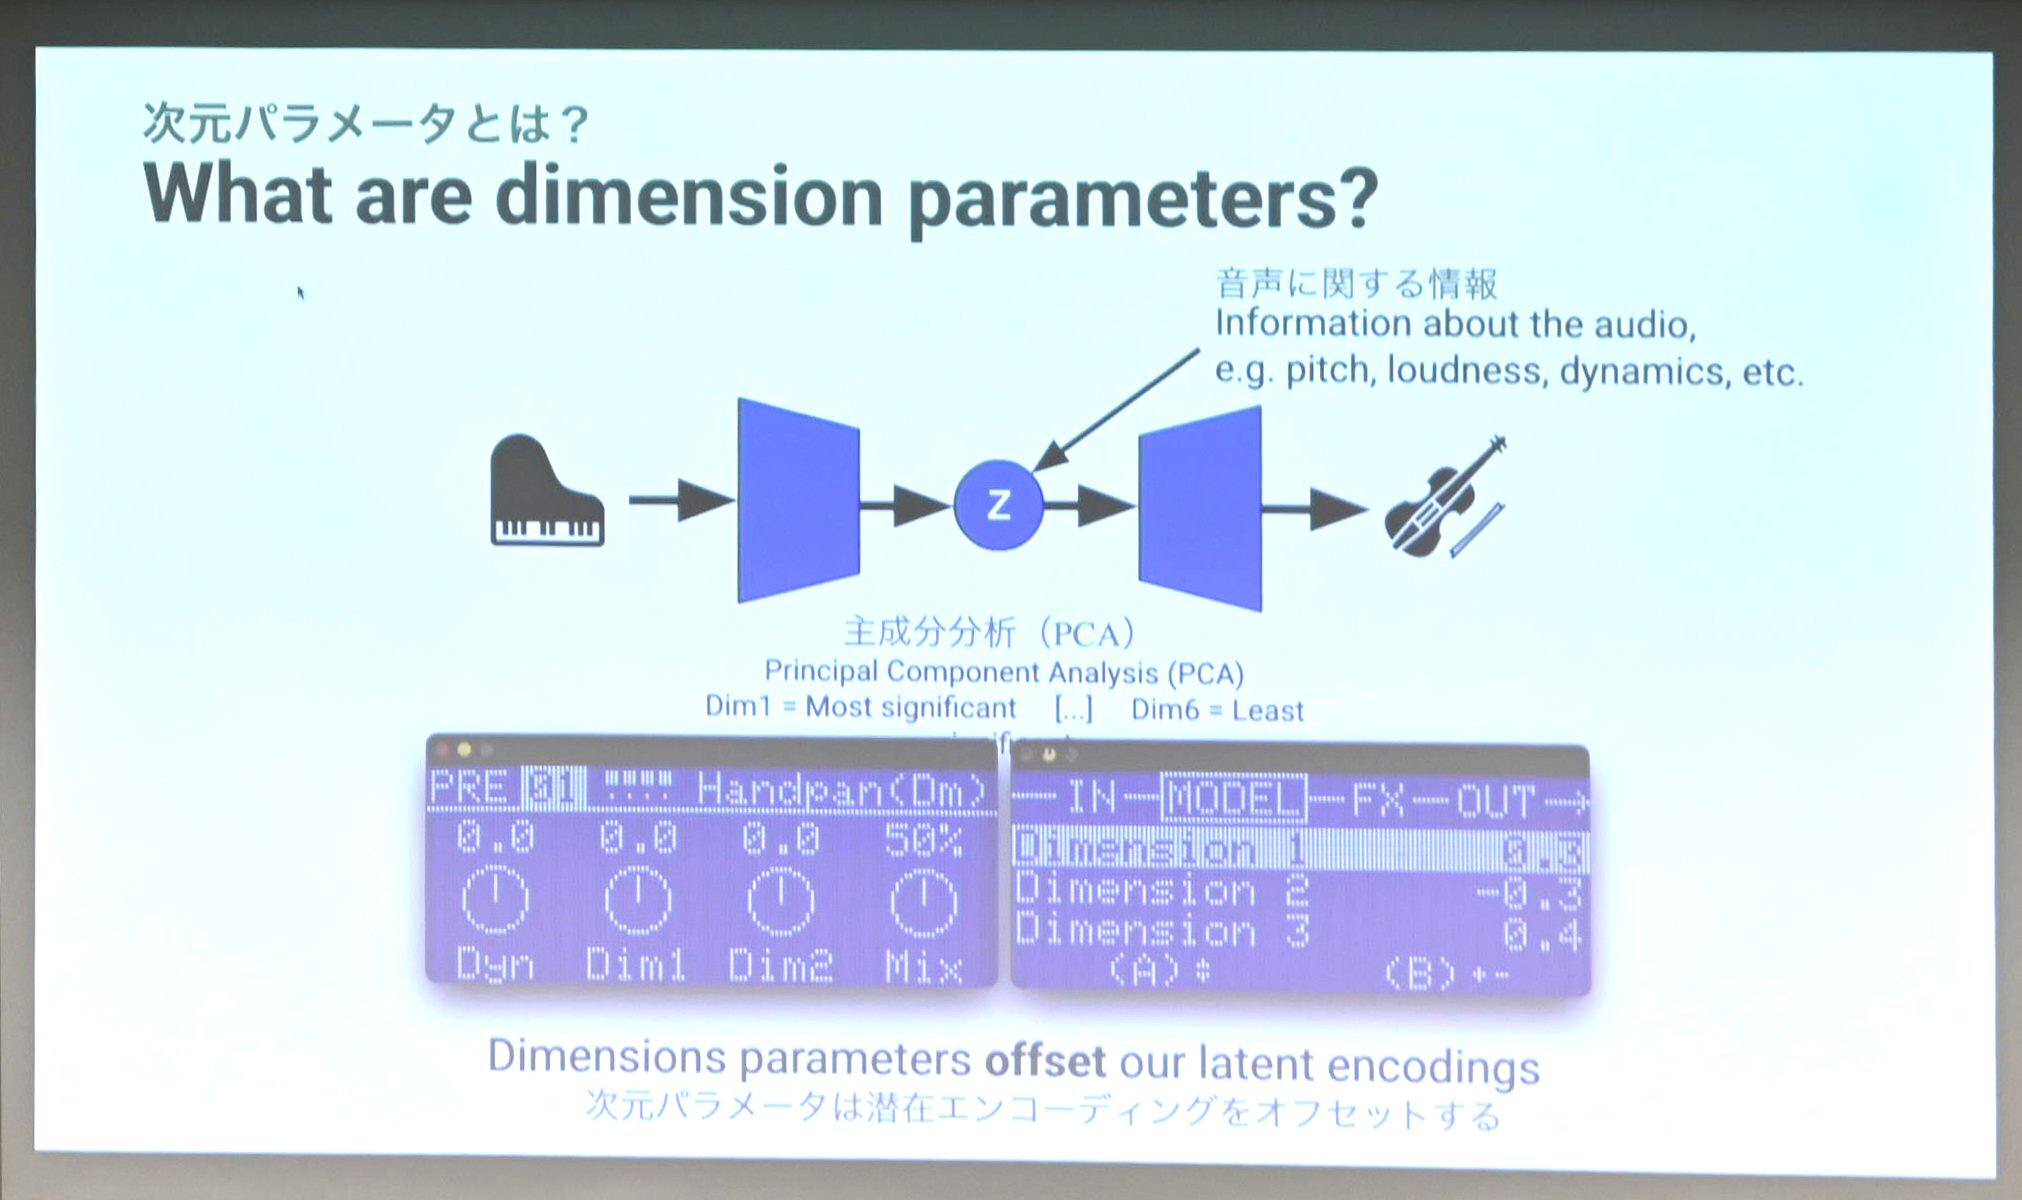
特に「Dimension 0(Dyn)」については「Dimension 0 = Dynamics (sort of!)」というスライドで詳しく解説されており、最初の次元は音量(ボリューム)に関連していることが多いものの、オフセット操作によって入力感度そのものが変わってしまう点や、Dim0の極性(プラス方向に振るとどうなるか)はモデルごとに異なる点が注意点として挙げられていました。「Dyn」パラメータは、Dim0のオフセットを入力ゲイン調整で相殺するためのものだと説明されています。
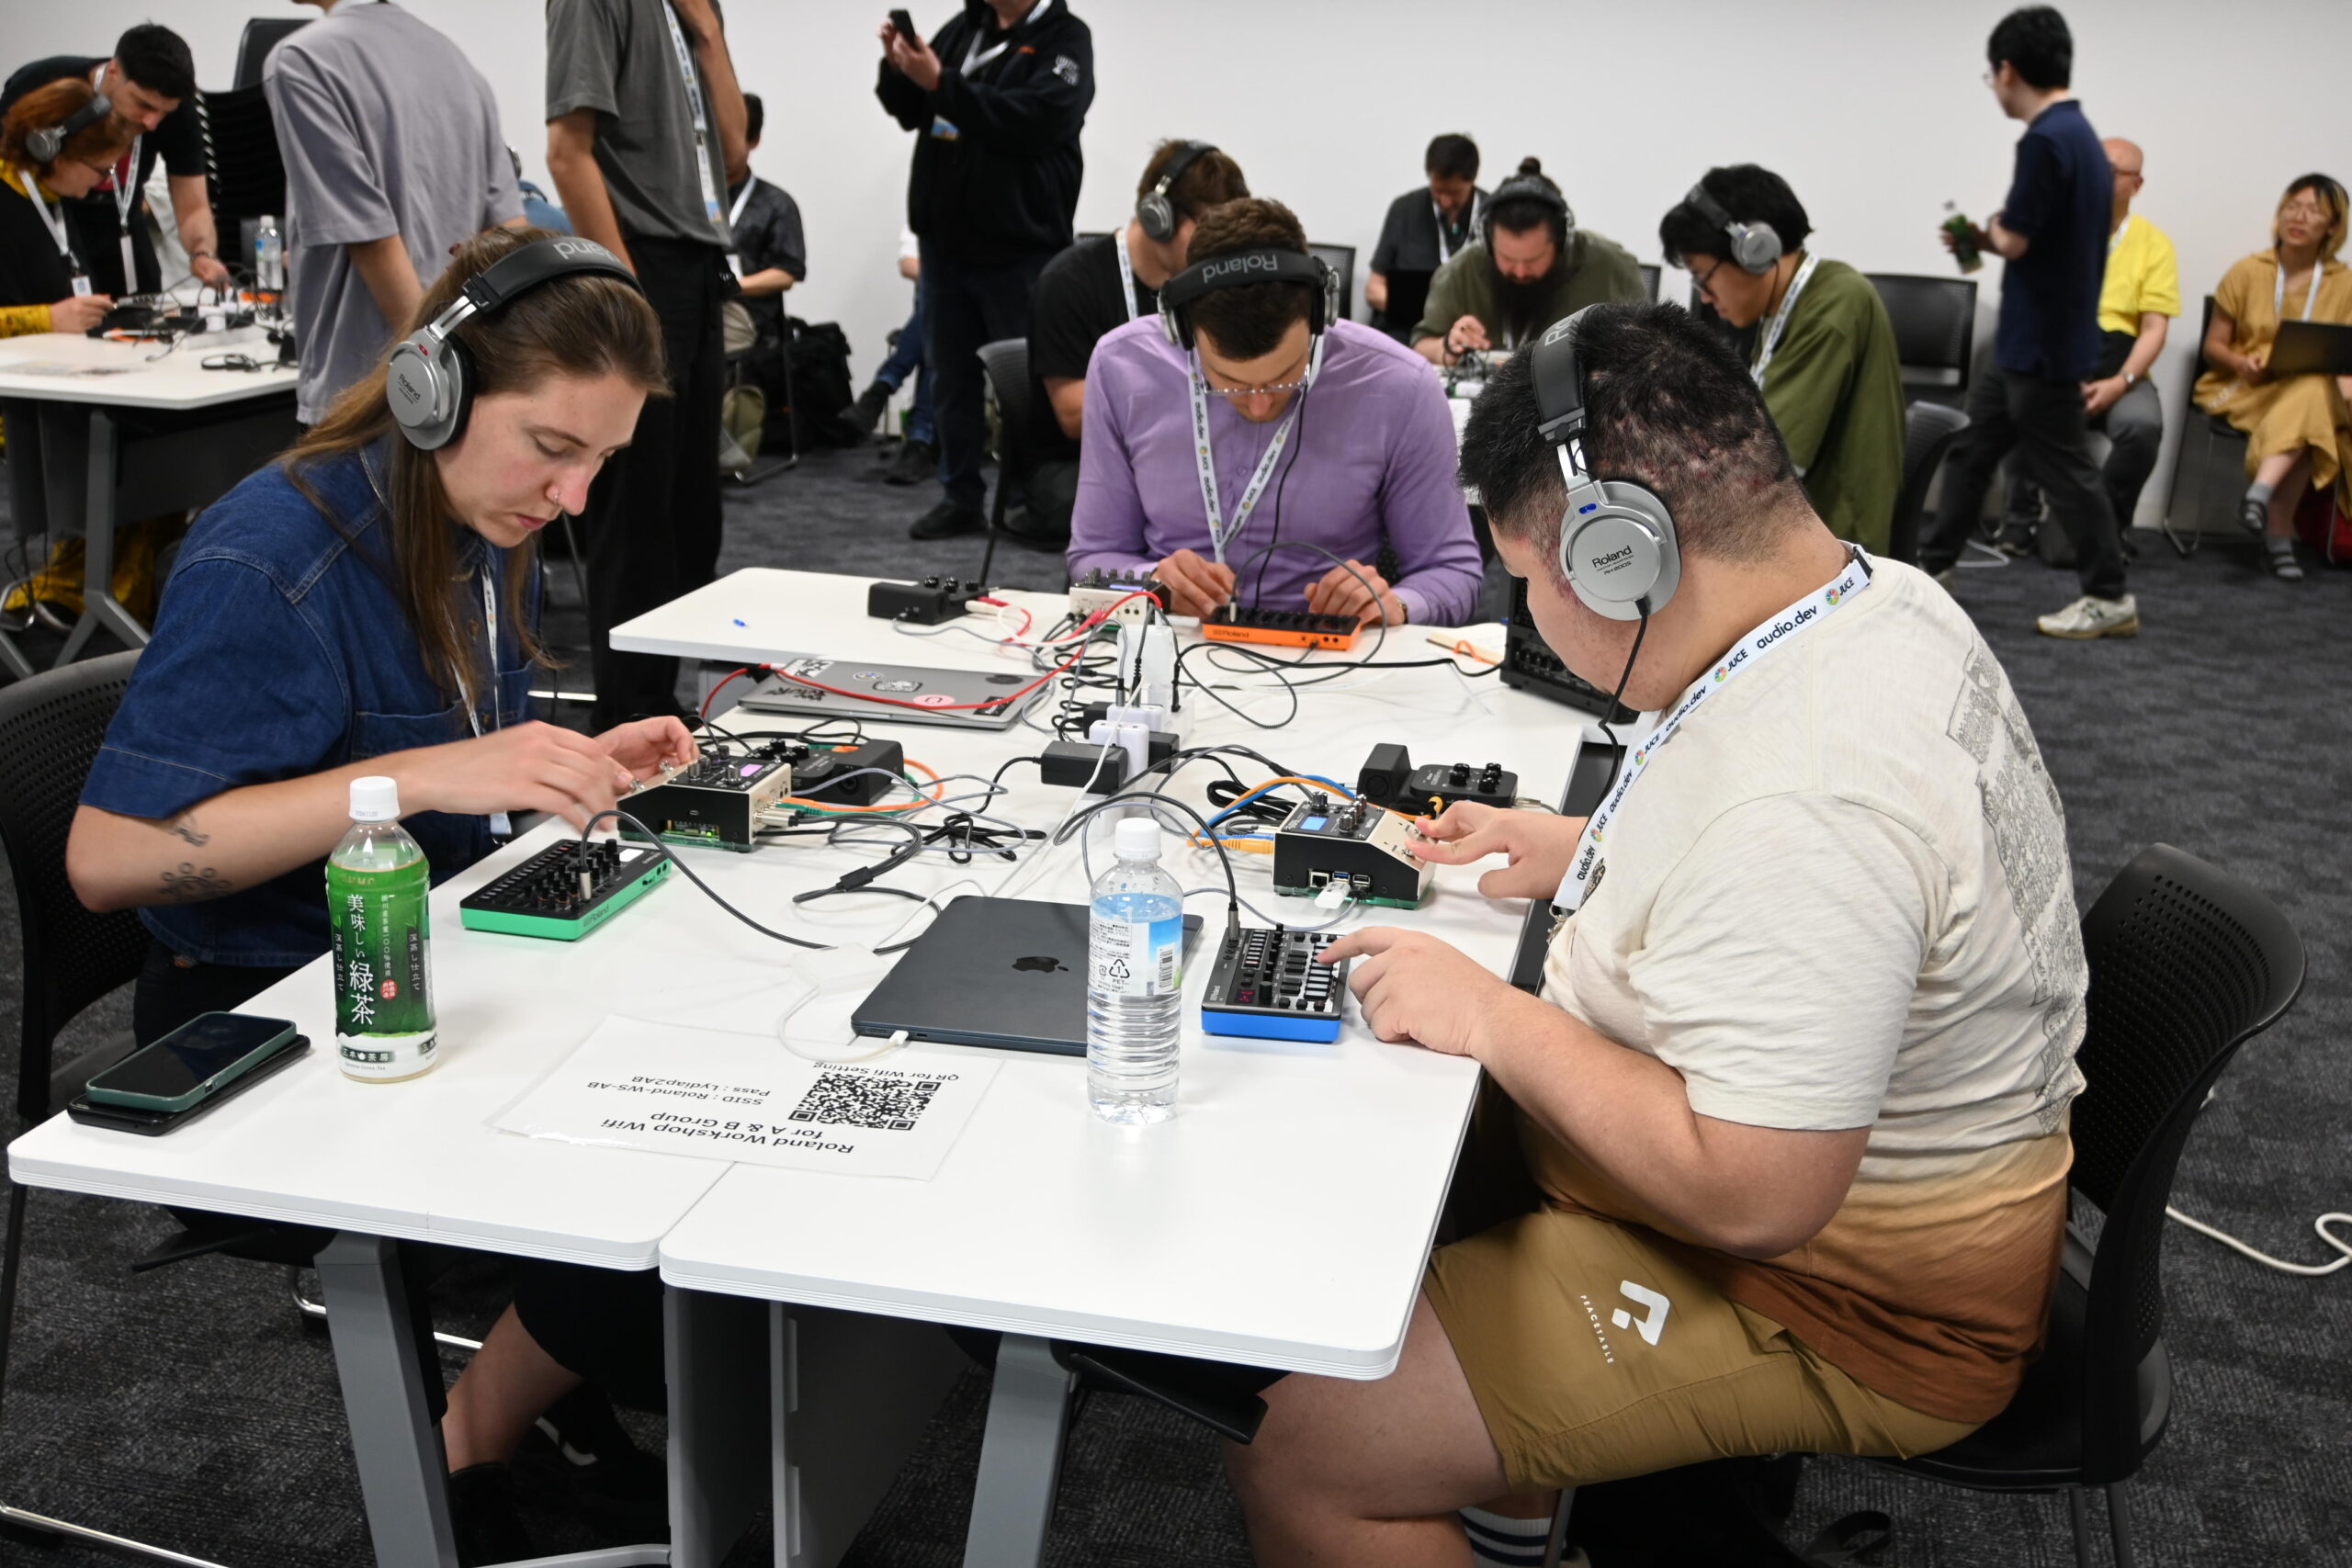
その後は「Let’s try.」のスライドとともに、参加者は実機のプリセットを実際に触りながら、「ディメンションパラメータは音をどう変えるか」「ダイナミクスノブは音をどう変えるか」「入力信号を変えると出力はどう変わるか」を体験していく、という流れでワークショップが進行しました。
開発陣に聞く——ローランドとNeutoneが目指すもの
セッション後、ローランドのCloud本部・本部長である岡村洋司さん、矢澤一郎さん、NeutoneのCEOの徳井直生さんに、それぞれお話を伺うことができました。
Roland Future Design Labとは
岡村さんによれば、Roland Future Design Labは2024年に設立された社内部署で、新しい技術の研究開発に特化した組織です。現在はAI関連の取り組みに力を入れていますが、イマーシブオーディオ空間の提供やWeb3へのアプローチなど、新しい技術をいかに楽器や音楽に応用するかを研究するR&D部門であり、即座の製品化を前提とした部署ではないとのことです。同部署からは既に、音楽のフレーズにマッチした音色をAIが提案する「トーンエクスプローラー」というアプリケーションが、ソフトウェアプラグインへの組み込みという形でPOC(概念実証)段階まで進んでいるそうです。
「人の置き換え」ではなく「人のサポート」
LYDIAが掲げるコンセプトは大きく2つ。ひとつは「人のクリエイティビティを増幅する」——AIがインスピレーションを与え、新しい着想や音楽表現につなげること。もうひとつは「人にできないことをサポートする」——例えばドラマーがギターのフレーズを弾けなくても、AIがそのリズムに合ったフレーズを演奏してくれる(あるいはその逆)、といった形です。岡村さんは、ローランドの歴史そのもの——例えばTR-808が「新しい音楽を作った」と言われるのも、それを使いこなしたミュージシャンがいたからこそだ——を引き合いに、AIによる人の置き換えではなく、あくまで人と組み合わさって新しい音楽が生まれる、というスタンスを強調していました。
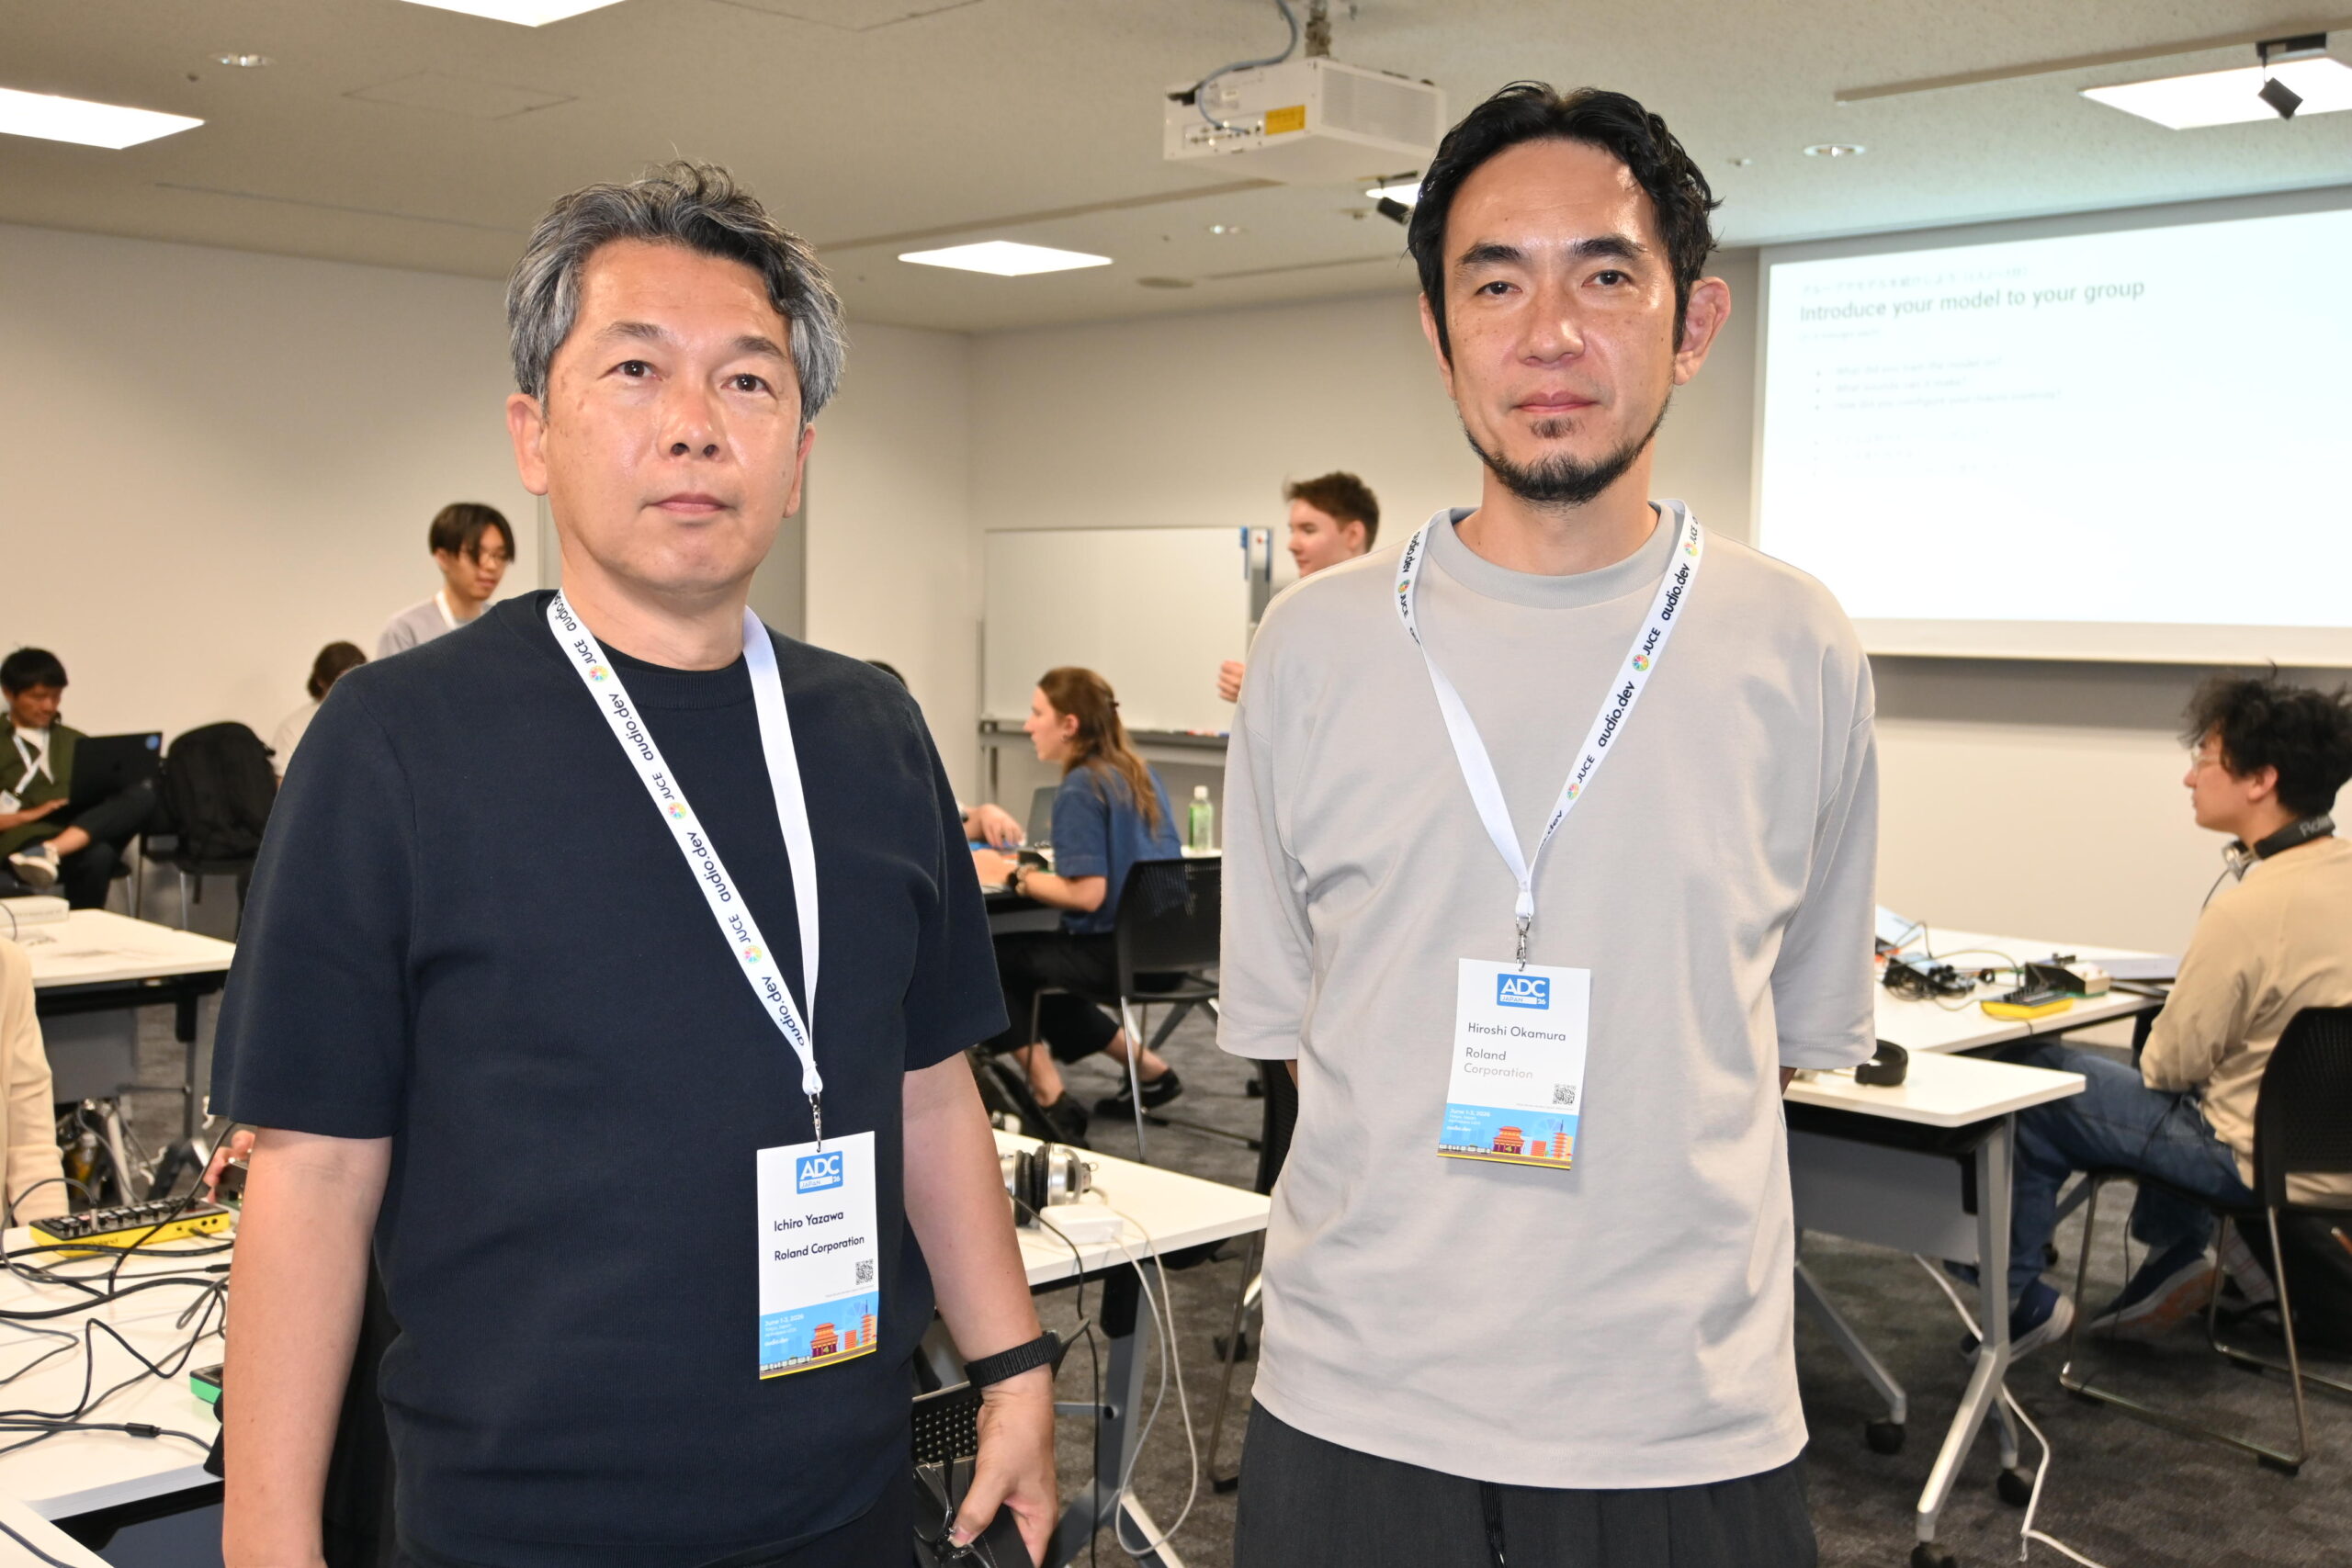
Rolandの矢澤一郎さん(左)と岡村洋司さん(右)
役割分担とレイテンシー競争
役割分担としては、ハードウェアとオーディオインターフェース部分をローランドが、AIの「頭脳」部分をNeutoneが担当しています。矢澤さんによれば、発表当初のフェーズ1の段階ではUSBオーディオインターフェースを外付けする構成だったものが、現在のフェーズ2では筐体内にコーデックを統合し、Raspberry Piから直接制御する方式に変更されており、これがレイテンシー短縮の大きなポイントになったとのことです。
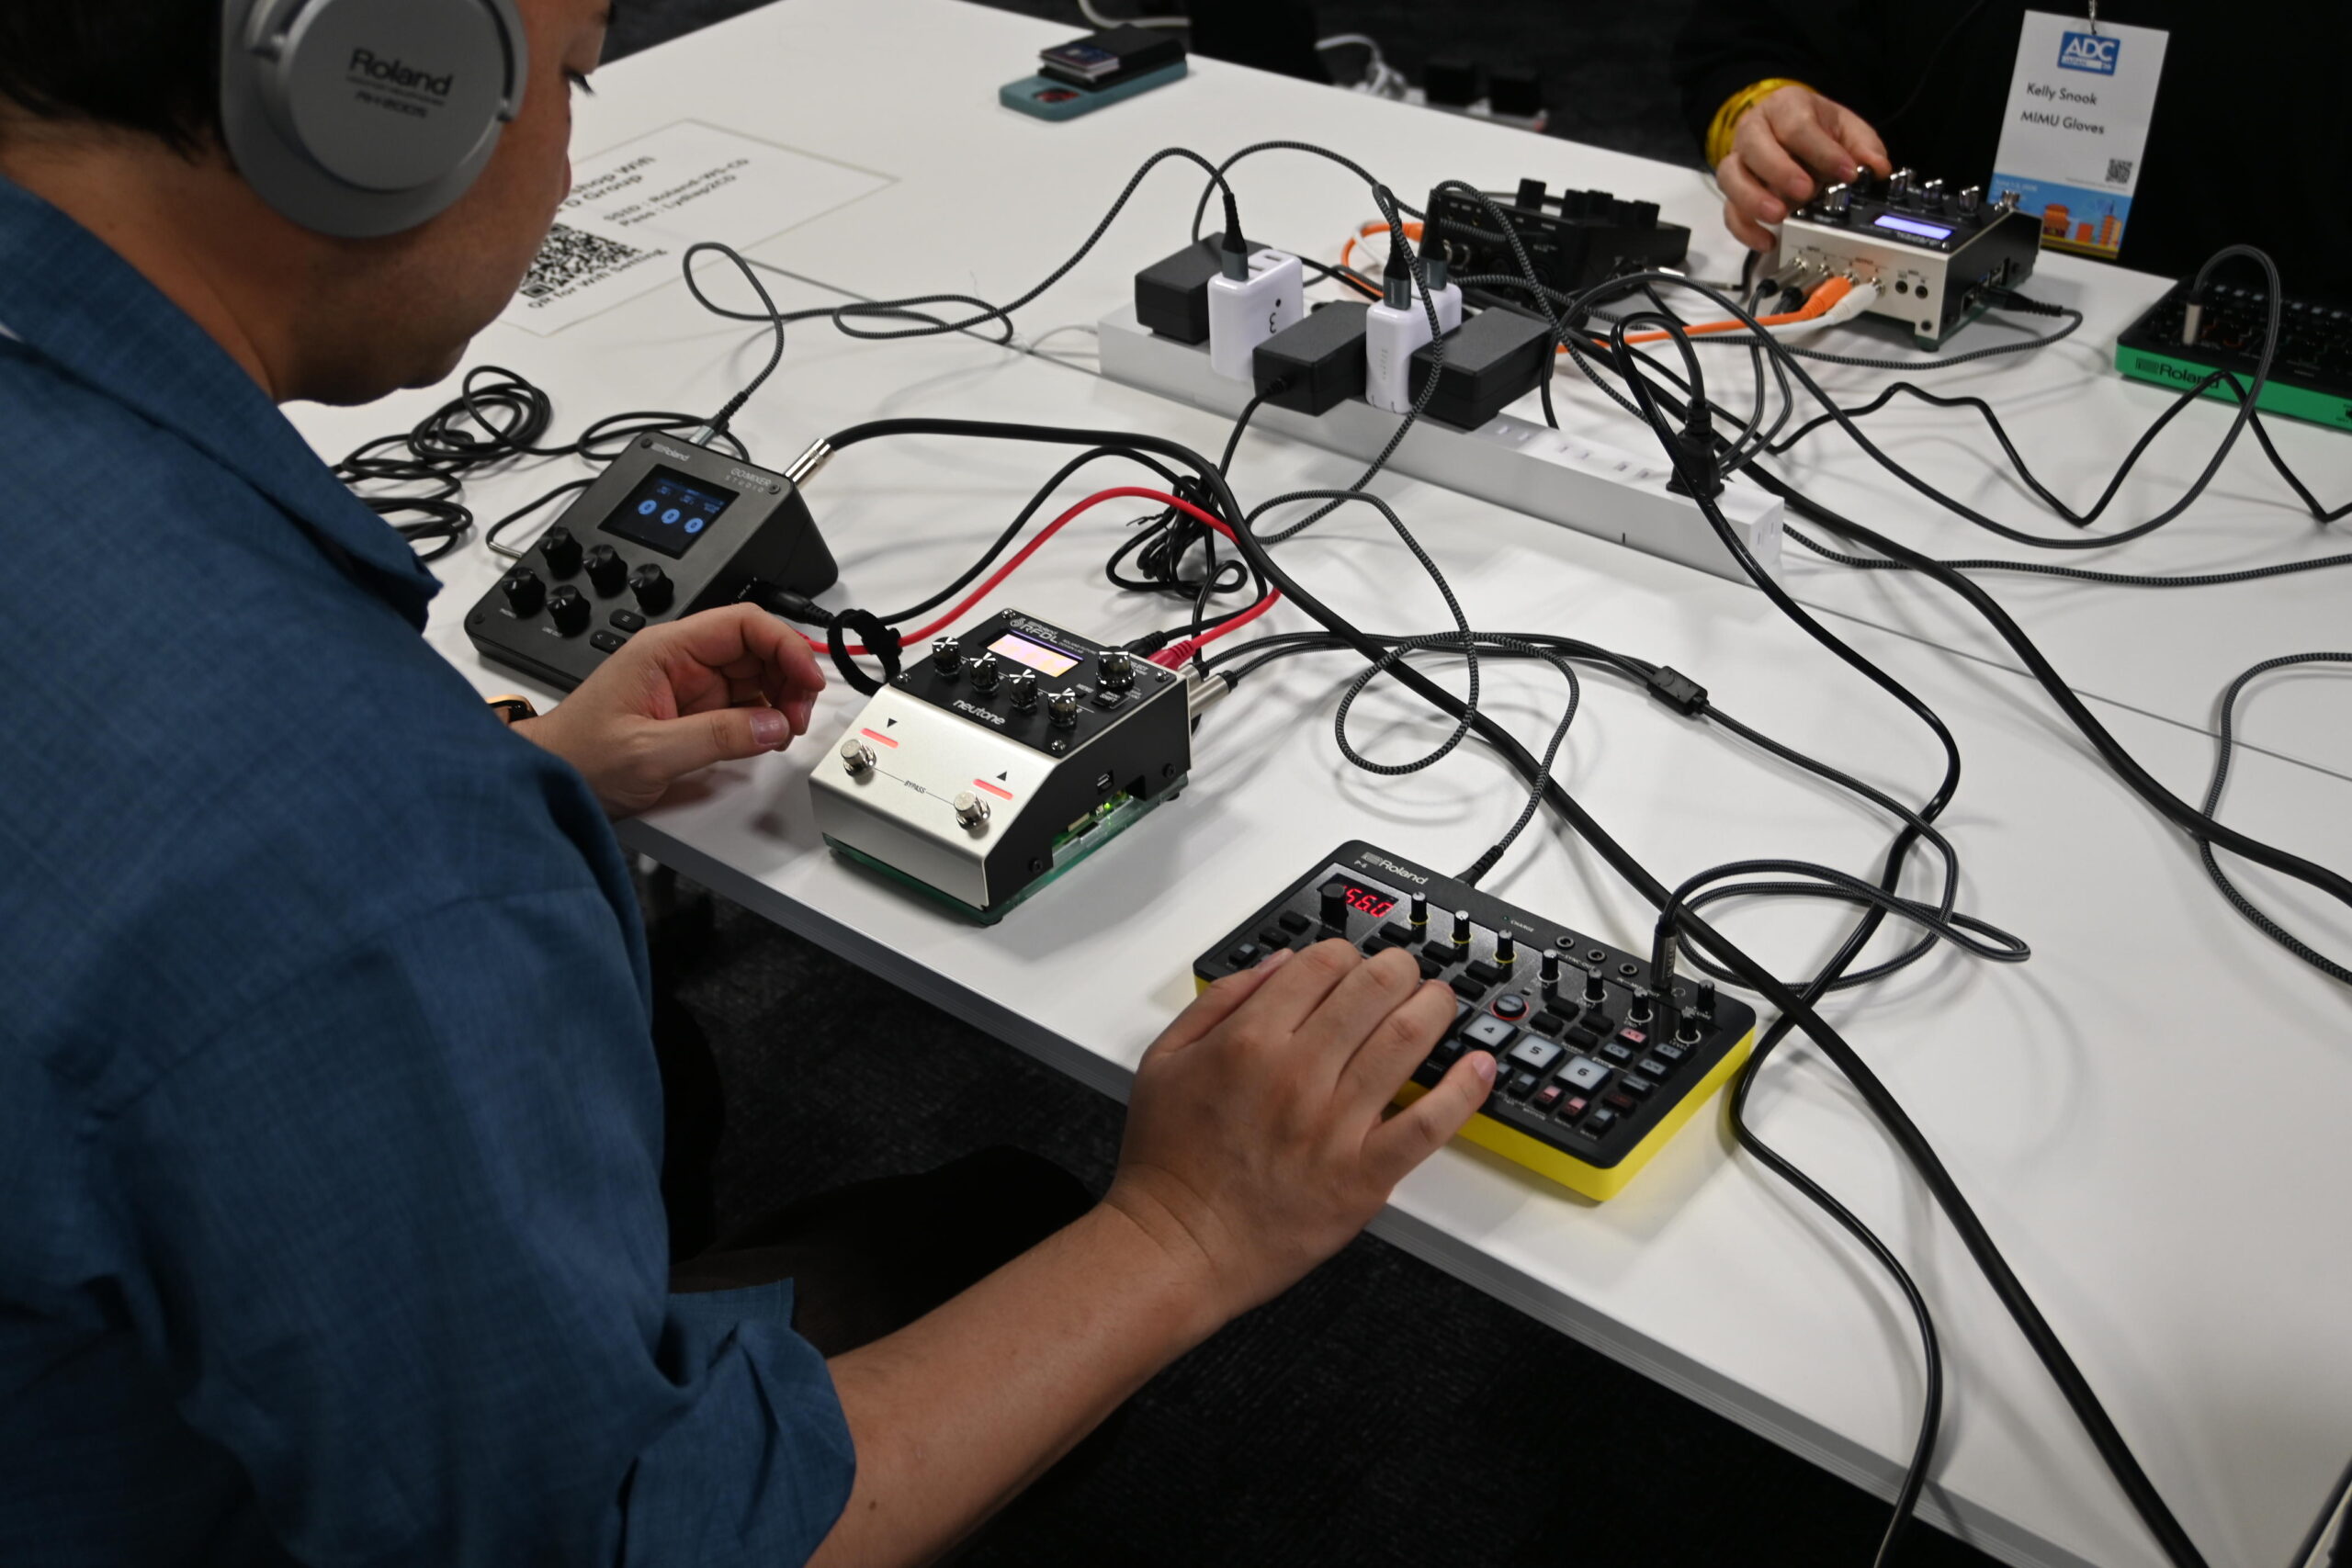
現状はまだPOC段階で、今回のハードウェアも新規に金型を起こすのではなく、既存の機構部品を組み合わせて実現したものだといいます。製品化の時期は未定ながら、参加者からの反応が良いため「できれば何とか製品化したい」という意向があるとのことでした。
Neutoneの成り立ちとMorpho
徳井さんによれば、Neutoneはプロジェクトとしては2022年に始動。オープンソースのAIモデルをDAW上で簡単に動かす仕組みとして公開したのが最初で、そこから世界中の研究者やエンジニアを巻き込みながら発展し、2023年に会社化されました。最初のプロダクトである音色変換プラグイン「Morpho」は2024年4月に発売され、現在も販売中です。ローランドとの接点はMorpho発売後にでき、2024年頃からハードウェア化プロジェクトが動き出し、2025年にプロトタイプ発表に至ったとのことです。
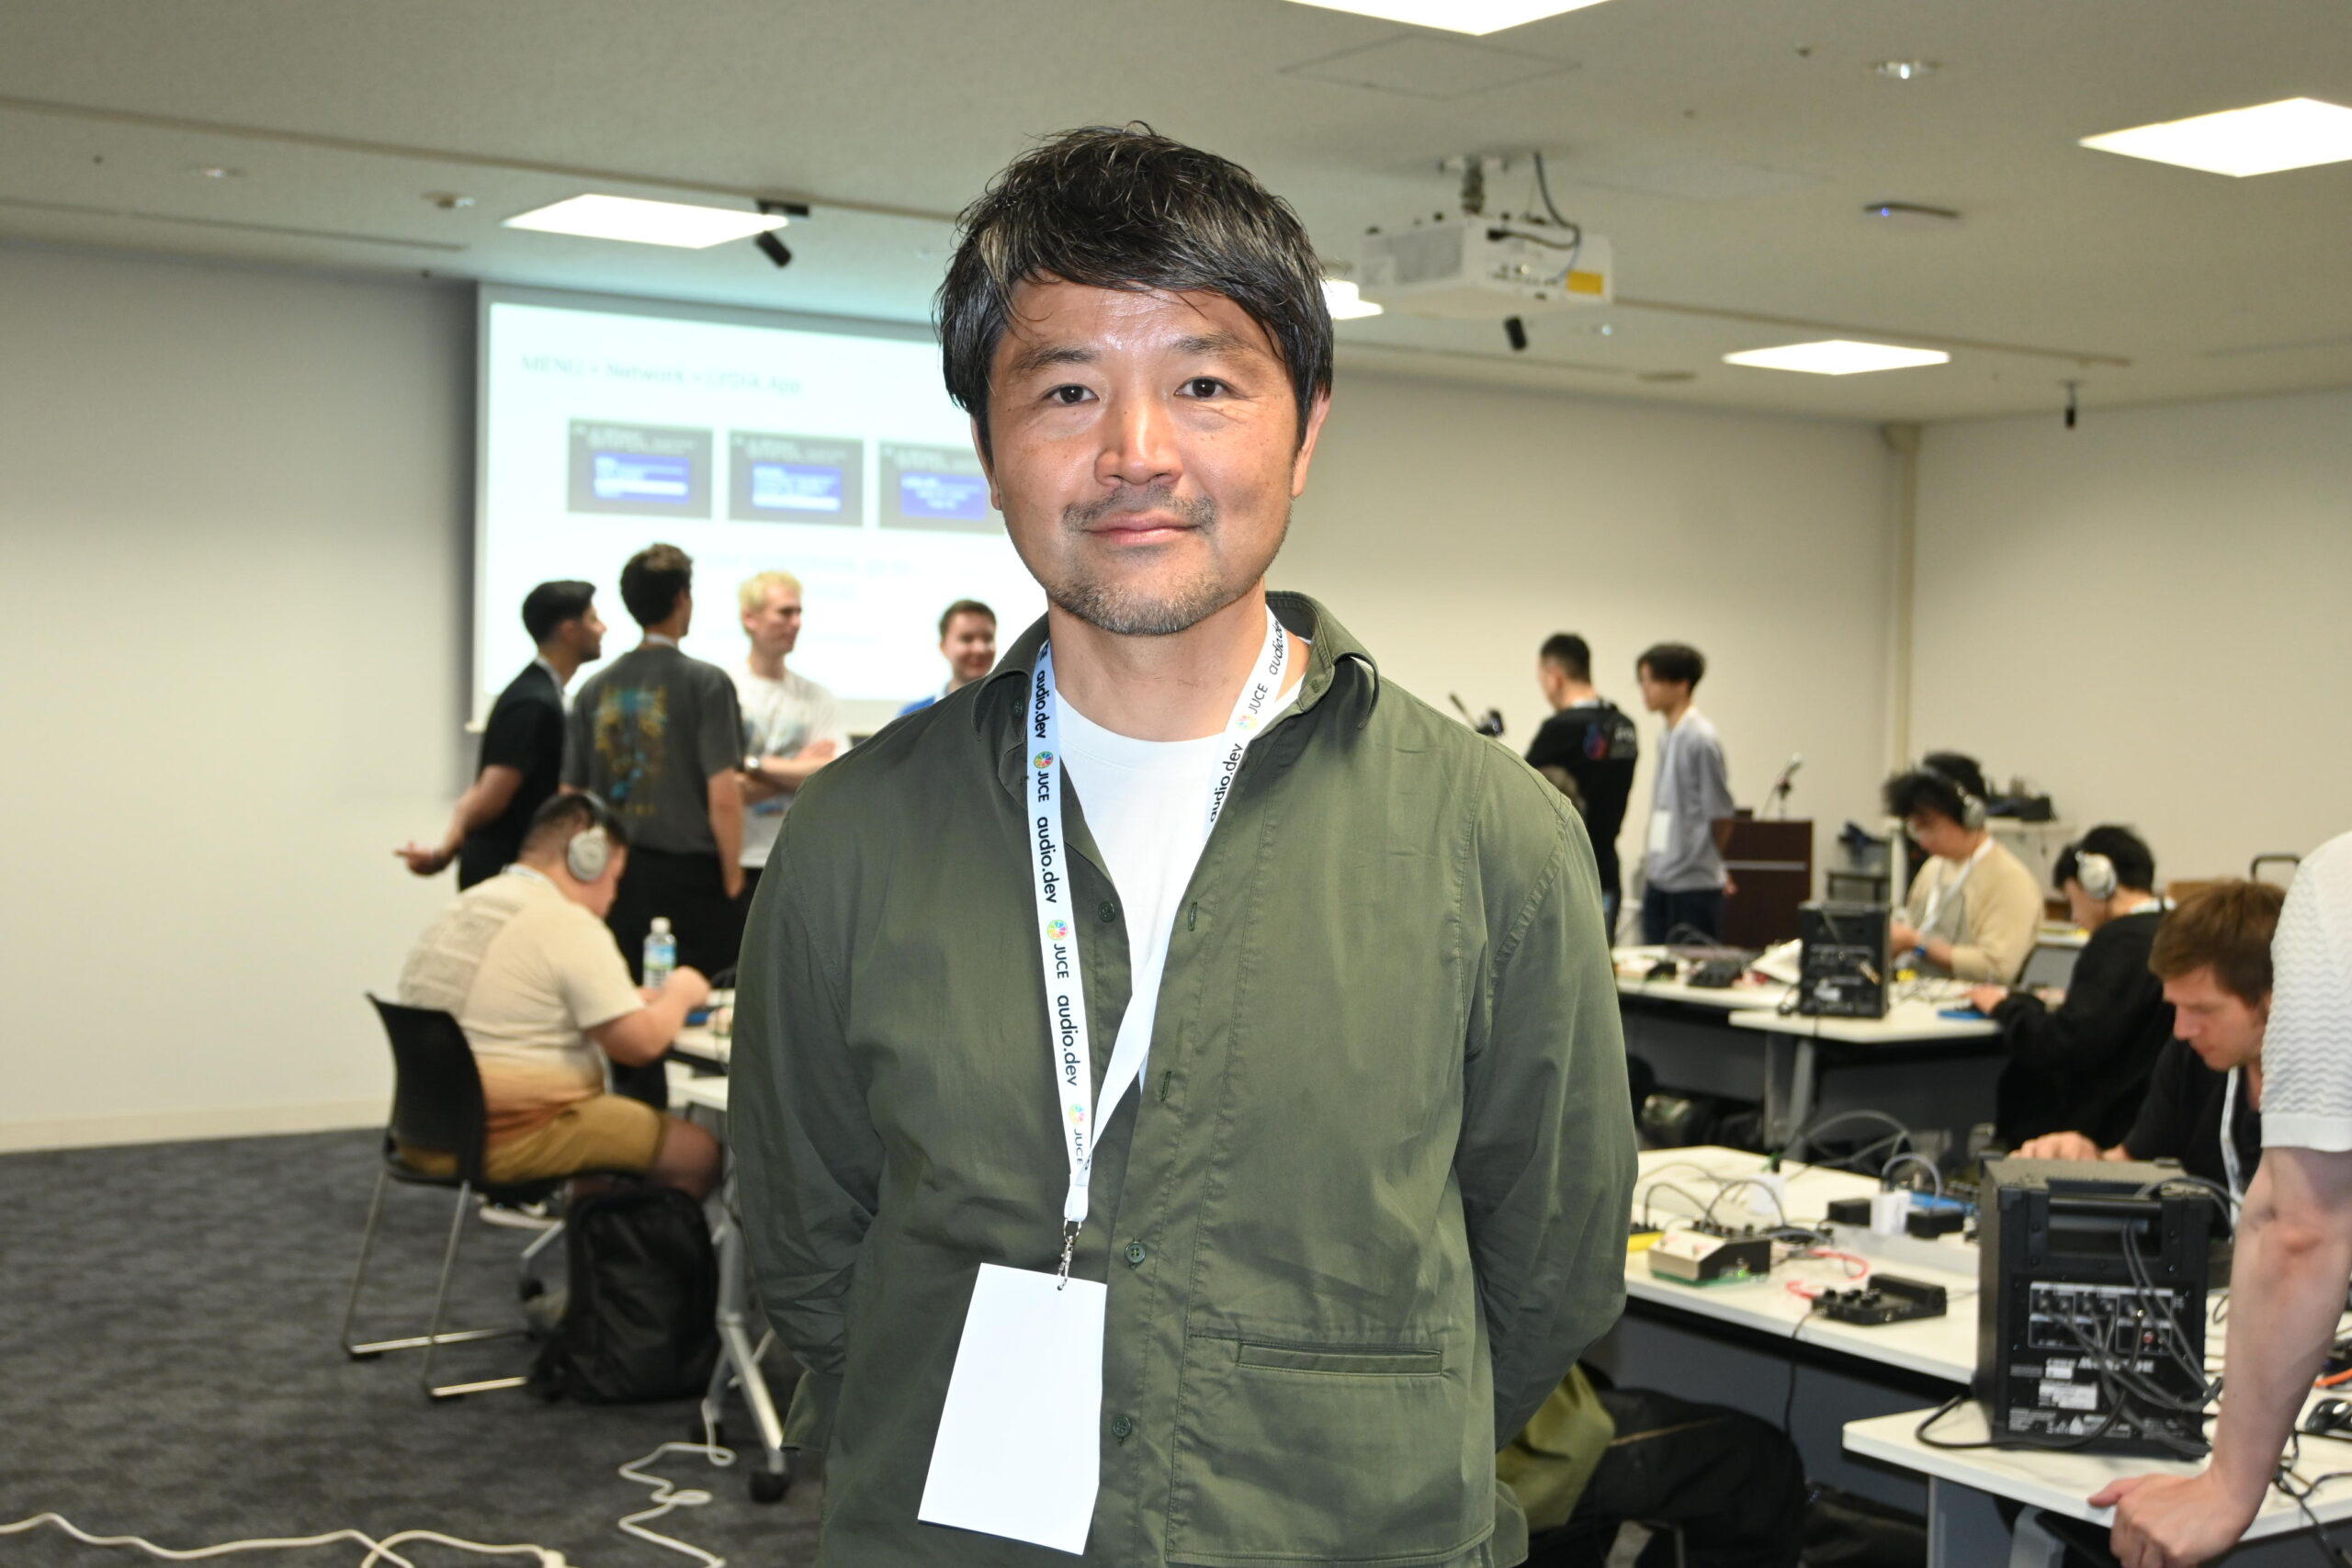
Neutoneの徳井直生さん
技術的には、人間にわかりやすく説明する際には「ピッチ」「ラウドネス」「ノイズ」の3要素として語られますが、実際にモデルが学習しているのは64個ほどの特徴量で、これは人間が設計した軸ではなく機械学習によって自動的に見出されたものだといいます。1〜2時間分の音源をクラウドにアップロードすると数時間の学習を経て専用モデルが返ってくる仕組みで、今回のワークショップ参加者にも、事前に学習済みの自分専用モデルが実機に読み込まれた状態で配布されていました。
徳井さんは、「今のAI技術はどちらかというと勝手に作ってしまう方向に向かっている」とした上で、Neutoneが目指すのはその逆——シンセサイザーやエフェクターの延長線上で、ミュージシャンが自ら演奏し、探求するためのAIの使い方だと語っていました。なお、ローランドとの関係は独占契約ではなく、Neutoneは今後も他社との取り組みを模索しうる立場とのことです。
定点観測してきたLYDIAの進化
実は、今年1月のNAMM Show、5月のSUPERBOOTHでもLYDIAの展示を取材しており、ADC Bristolでのプレビュー発表以降、断続的にこのプロジェクトを追いかけてきたことになります。インタビューにあったフェーズ1(USBオーディオインターフェース外付け)をNAMMで、フェーズ2(筐体内蔵)をSUPERBOOTHそしてADC Japanで見てきており、半年の間に確実に進化してきたのも目にしてきました。ハードウェアとしての完成度は着実に上がってきており、今回のADC Japanでのワークショップ形式での一般公開は、開発陣にとっても大きな一歩だったようです。
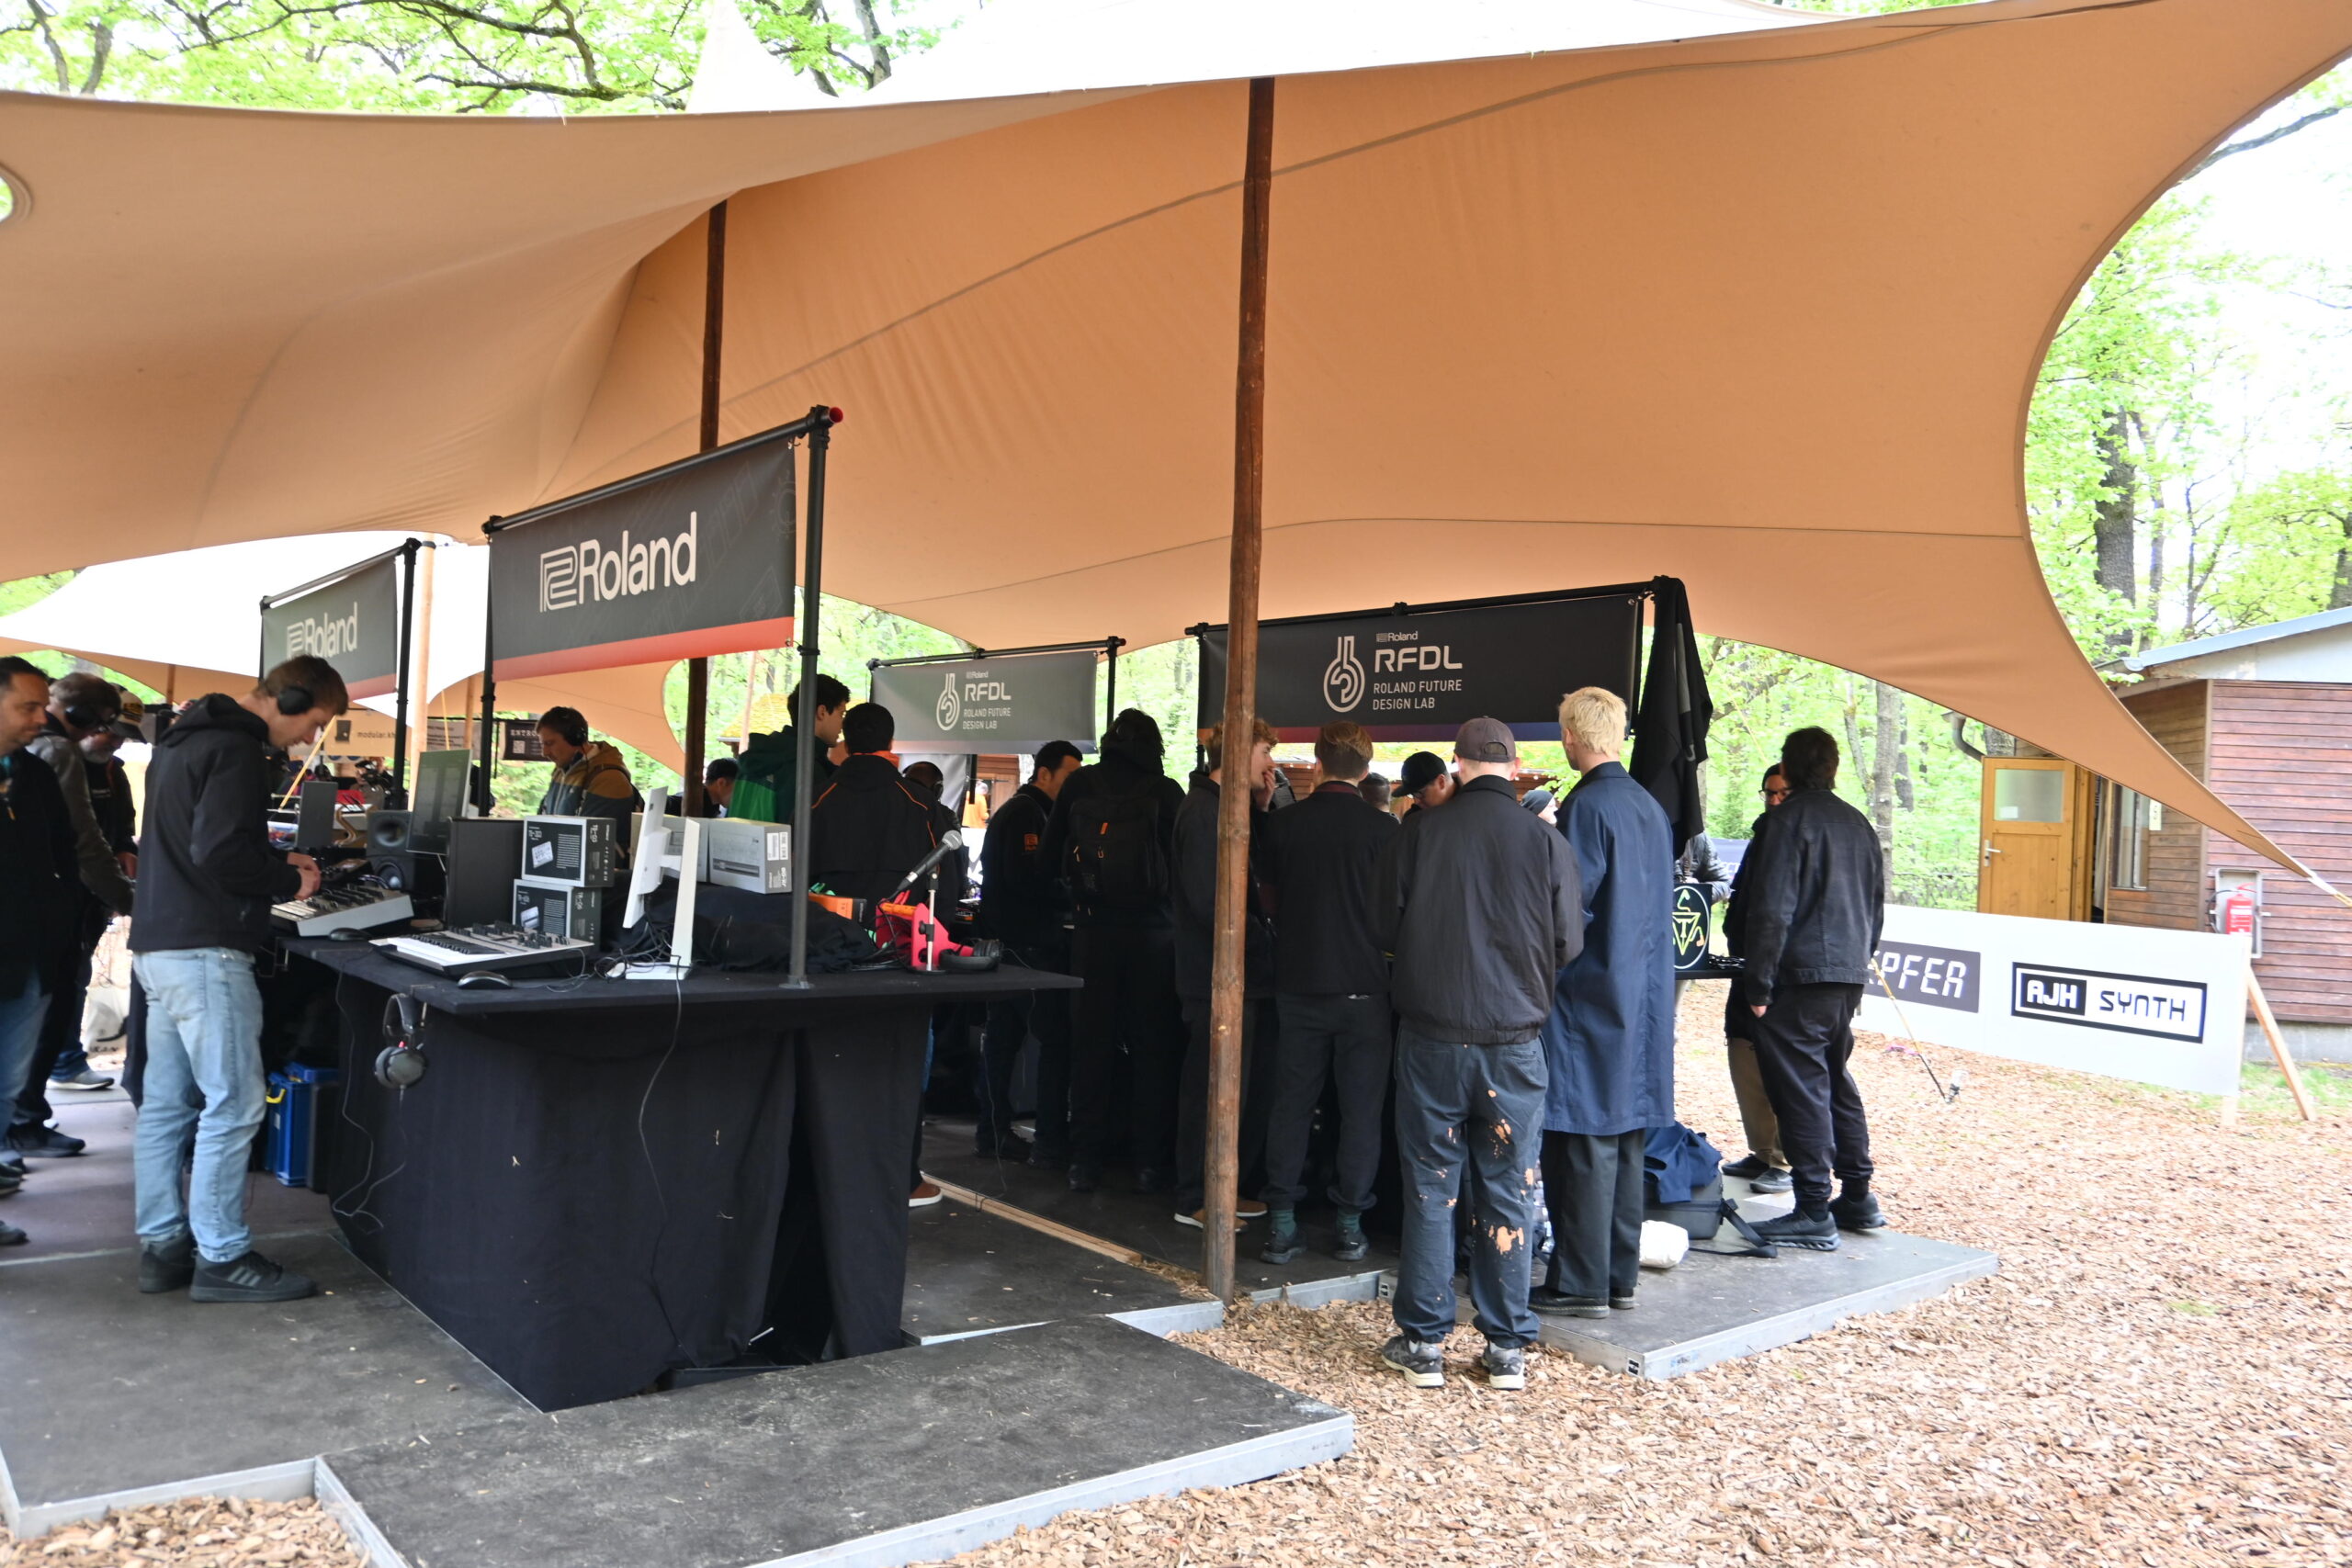
5月にドイツ・ベルリンで行われたSuperboothでのRolandブース
おわりに
ADC Japan 2026は、秋葉原UDXでの開催という国内初の大規模オーディオ開発者カンファレンスとして、多くの技術・製品・コミュニティの話題を提供してくれました。全6回にわたるこのレポートシリーズでは、ヤマハのSVS×DAW統合、初音ミクを支える加算合成エンジンM9、WebアプリをそのままVSTプラグイン化する技術、日本の電子楽器100年史、そして今回のProject LYDIAと、実に幅広いテーマを取り上げることができました。ローランドとNeutoneが目指す「人と共に新しい音楽を作るAI」という方向性は、ADC Japanという場全体に流れていた空気とも重なるものだったように思います。製品化の続報が届く日を楽しみに待ちたいと思います。
【関連記事】
▶ 秋葉原UDXで開催された第1回ADC Japan 2026。オーディオ開発者のための国際カンファレンスがついに日本上陸
▶ ヤマハが描く「DAWが歌う未来」——SVSをDAW統合するための4つの課題とは?【ADC Japan 2026レポート②】
▶ 初音ミクの歌声を支える加算合成エンジンM9の秘密——クリプトンが明かした基幹技術と今後の展開【ADC Japan 2026レポート③】
▶WebアプリがそのままVSTプラグインになる!? Chromiumで実現する新時代のプラグイン開発、その驚きの仕組み【ADC Japan 2026レポート④】
▶テルミンより前?いや同時代だ!日本の電子楽器100年史をコルグ・三枝文夫さんがひも解く【ADC Japan 2026レポート⑤】
【関連情報】
ADCサイト
ADC Japan 2026サイト
ローランドとNeutoneの共同研究によるAIを活用した次世代オーディオ・エフェクト技術『Project LYDIA』のプレビュー版を発表(Rolandプレスリリース)
ローランドとNeutoneの共同研究によるAIを活用した次世代オーディオ・エフェクト技術『Project LYDIA』のフェーズ2を発表(Rolandプレスリリース)
Neutoneサイト


コメント